Skills
Skills 是组织的方法论:怎么规划一个查询、怎么诊断一次失败、某个口径在本组织里到底怎么算。 它与知识库的分界很清楚——知识库装某个数据源的事实, Skills 装跨数据源通用做法。
放哪:Skills 还是 KB?
这是使用中最常被问的问题,判据只有一条:这条知识换一个数据源还成立吗?
| 内容 | 放哪 | 理由 |
|---|---|---|
「loan.amount 单位是元」 |
KB | 这是某张表的字段事实 |
| 「比率类指标的分母要排除已核销」 | KB(rules.yml)或 skills |
取决于它是这个库的口径还是全组织的口径 |
| 「遇到多跳问题先确定事实表再补维度表」 | Skills | 换任何库都成立的方法论 |
| 「执行报字段不存在时先查 schema 再改,不要猜列名」 | Skills | 诊断方法,与具体表无关 |
代码里自带的两个 code skill 正好是后两类的例子:plan_query(怎么规划)、
diagnose_failure(怎么诊断失败)。
它们放在 trove/prompts/skills/ 下,随代码走,是事实上的必需品。
两个来源,合并渲染
| 来源 | 位置 | 谁能改 |
|---|---|---|
| code skills | trove/prompts/skills/ | 改代码(只读资产,事实上的 required) |
| org skills | .trove/skills/<name>/SKILL.md | 管理端,走确认门禁 |
service.py:168 SkillService service.py:302 list_code_skills service.py:275 list_org
四档:注入、按需,以及两种不注入只断言
每个 skill 声明自己的档位。这个选择直接影响生成提示的长度, 而提示长度直接影响成本与注意力分配——所以不该「全都塞进去」。 前两档是给模型读的,后两档不是——validator 判结果、guard 判 SQL, 都由引擎执行、零 LLM。
| tier | 进什么 | 什么时候用 |
|---|---|---|
| required | 正文全文注入到匹配节点的系统提示里 | 每次都该遵守的硬约束(如「不许猜列名」) |
| available | 只把描述作为 <available_skills> 块广告出去,正文按需取 |
场景性的方法论,多数提问用不上 |
| validator | 正文从不进模型——它是一份给引擎执行的断言清单,跑在结果上 | 组织自己不可让步的口径(如「金额不许为负」),要拦在交付前 |
| guard | 正文从不进模型——同样是给引擎执行的断言清单,但跑在生成的 SQL 上 | 组织不可让步的写法底线(如「聚合查询必须带 WHERE」),要拦在执行前——执行与交付都还没发生 |
flowchart TB
    S["SKILL.md 声明 tier"]:::entry --> R["required
正文全文注入匹配节点的系统提示"]:::gen
    S --> A["available
只广告描述,正文经 load_skill 工具按需取"]:::gen
    S --> V["validator
正文从不进模型,是给引擎执行的断言清单"]:::gate
    S --> G["guard
正文从不进模型,是给引擎执行的 SQL 断言清单"]:::gate
    R --> P["模型读 → 生成 SQL"]:::gen
    A --> P
    P --> E["execute_sql 节点
guard 在授权门之后、执行之前判定"]:::exec
    G --> E
    E --> E1["通过 → 执行"]:::entry
    E --> E2["违反 · blocking → 回滚重算(目标可收窄)"]:::err
    E --> E3["违反 · advisory → 只进 guard_hits 附注"]:::entry
    E --> E4["判不了(SQL 解析失败)→ 绝不拦"]:::entry
    E1 --> X["validate 节点
零 LLM,逐条判定结果"]:::exec
    V --> X
    X --> X1["通过 → 交付"]:::entry
    X --> X2["违反 · blocking → 回滚重算"]:::err
    X --> X3["违反 · advisory → 回答顶上一行提示"]:::entry
    X --> X4["判不了 → 只进 validator_hits,不上屏"]:::entry
    classDef entry fill:#71717a14,stroke:#71717a59,stroke-width:1px;
    classDef gen fill:#6366f114,stroke:#6366f199,stroke-width:1.5px;
    classDef exec fill:#14b8a614,stroke:#14b8a699,stroke-width:1.5px;
    classDef gate fill:#f59e0b14,stroke:#f59e0b99,stroke-width:1.5px;
    classDef err fill:#dc262614,stroke:#dc262699,stroke-width:1.5px;
required 级的 skill 不是全局生效的——它可以声明 triggers.node
来限定只注入到某几个节点(查询计划、失败分析、agentic 生成,以及展示环的
洞察 / 图表 / 结论 / 归因)。
没写 triggers.node 的才是全局。这个粒度是有必要的:
「怎么诊断失败」这条方法论对规划节点毫无用处,注进去只会稀释它的注意力。
按需加载怎么工作
available 级的 skill 靠一个工具取正文。这个工具只在真的有 confirmed 的 available skill 时才注册——没有的时候,模型看到的工具列表里根本没有它。
gen_sql.py:1185 load_skill_tool gen_sql.py:1051 build_sql_registry
一个用不到的工具不是中性的——它会占提示空间,还会给模型多一个犹豫的选项。所以这套系统里工具的注册普遍是条件的:按复杂度档位、按角色、按「有没有内容可返回」。
这和工具治理是同一个思路的两面。
validator 怎么运行
validator 档是一份声明,不是一段提示词:文件里写清要检查什么
(checks,逐条带 expr 与可选的 columns / severity),
由 validate 节点在规则链那一遍之后执行,零 LLM,
复用决策规则的同一个表达式引擎。可用的量就是结果自身的聚合:min /
max / sum / avg / null_count /
row_count / col_count。
每条断言给三值判定之一,落点各不相同:
| 判定 | 什么情况 | 落点 |
|---|---|---|
| 通过 | 断言为真 | 交付 |
违反 · blocking |
明确违反,且声明为拦 | 判词带进 error_feedback 回滚重算,同时作为一条拦截进 validation_hits;只有预算耗尽时才升级成交付给用户的错误 |
违反 · advisory |
明确违反,但声明只报告 | 不拦,渲染成回答顶上的一行「⚠️ 口径提示」 |
| 判不了 | 缺列、没声明 columns、结果超出展示窗口、结果本来就为空、列里没有数值、配置写错…… |
只进 validator_hits 供质检统计,永远不进用户屏幕 |
第三值单独占一格,不塌向任何一边——塌成「通过」是没查却报平安, 塌成「违反」是查不了却拦下正确结果,两种都比不检查更坏。它带一个机器可读的原因码, 因为「配了却判不了」的占比是这套机制唯一的质量信号:一句话盖住所有原因, 就再也数不出分布。
判不了不进附注的理由是噪声:一个高频出现、又多半只说明管理员该改配置的提示, 两周内就会把真正有意义的告警一起淹掉。
规则链(verify)是第一条失败即止、只回一个 reason,那是给「形状」用的——单值问题的结果必须一行一列。validator 要的是逐条判定 + 逐条 severity,一个 reason 装不下,所以它是紧挨着 verify() 的另一遍,不是它的扩展。
写入面与执行面共用同一份 severity 闭集。severity: Blocking(大小写错了)既未被拦、也不会被渲染——写入放行、执行侧当未知,正是这类「配了却静默失效」事故的来源,所以两处必须看同一份名单。
guard 怎么运行
第四档 guard 与 validator 是一对镜像:同样是正文从不进模型的
声明清单、同样零 LLM、同样三值判定与两档 severity。区别只在判什么、在哪判——
validator 看结果、在 validate 节点拦在交付前;
guard 看 SQL、在 execute_sql 节点拦在执行前。
宿主位置是写死的(GUARD_HOST = "execute_sql"),闸序是「授权门之后、
执行之前」——安全先于质量:一条没通过授权门的 SQL,轮不到守卫发表意见。
guard 能用的量是一组 SQL 结构变量的闭集,全部是 int 的 0/1:
select_star / table_count / join_count /
has_where / has_limit / has_time_predicate /
has_aggregate / cte_count / sql_len。
布尔语义用 0/1 而不是 true/false 是刻意的:引擎的取值函数对布尔类型返回
None——写成 true 的守卫不会报错,只会每条都判不了、永不生效。
这正是本页反复出现的「配了却静默失效」事故类型,所以从类型上就把域收死;
写入口(create / 导入)对域外标识符还有一道位置级校验,直接 400 指到出错的位置。
判定的落点沿用与 validator 相同的三值规矩:
| 判定 | 什么情况 | 落点 |
|---|---|---|
| 通过 | 断言为真 | 继续执行 |
违反 · blocking |
明确违反,且声明为拦 | 记为 ORG_GUARD 类错误回滚重算;失败分析节点对它走零 LLM 的确定性分流——指出是哪条守卫、哪个变量越了线,不把它当普通报错猜。回滚目标在声明里可收窄到 gen_sql / query_sketch / schema_linking(默认回到生成) |
违反 · advisory |
明确违反,但声明只报告 | 命中记进 guard_hits 附注,不改执行 |
| 判不了 | SQL 解析失败(此时全部变量为 UNKNOWN) | 绝不拦——守卫的失败方向是「放过」,而不是误杀一条正确的 SQL |
guards.py:45 GUARD_HOST guards.py:55 GUARD_VARIABLES execute_sql.py:62 ORG_GUARD_TAG analyze_error.py:496 ORG_GUARD_TAG
确认门禁:草案不进提示
org skill 的写入走的是和 KB 教训/示例同一套门禁:
新建即 pending,待确认的草案既不会进提示、也不会出现在
load_skill 工具的可取范围里——等于不存在。
这条一致性很重要:Skills 直接写进系统提示,影响力比 KB 条目更大。 如果草案能进提示,那「AI 自己写方法论给自己看」就成了一个自我强化的回路。
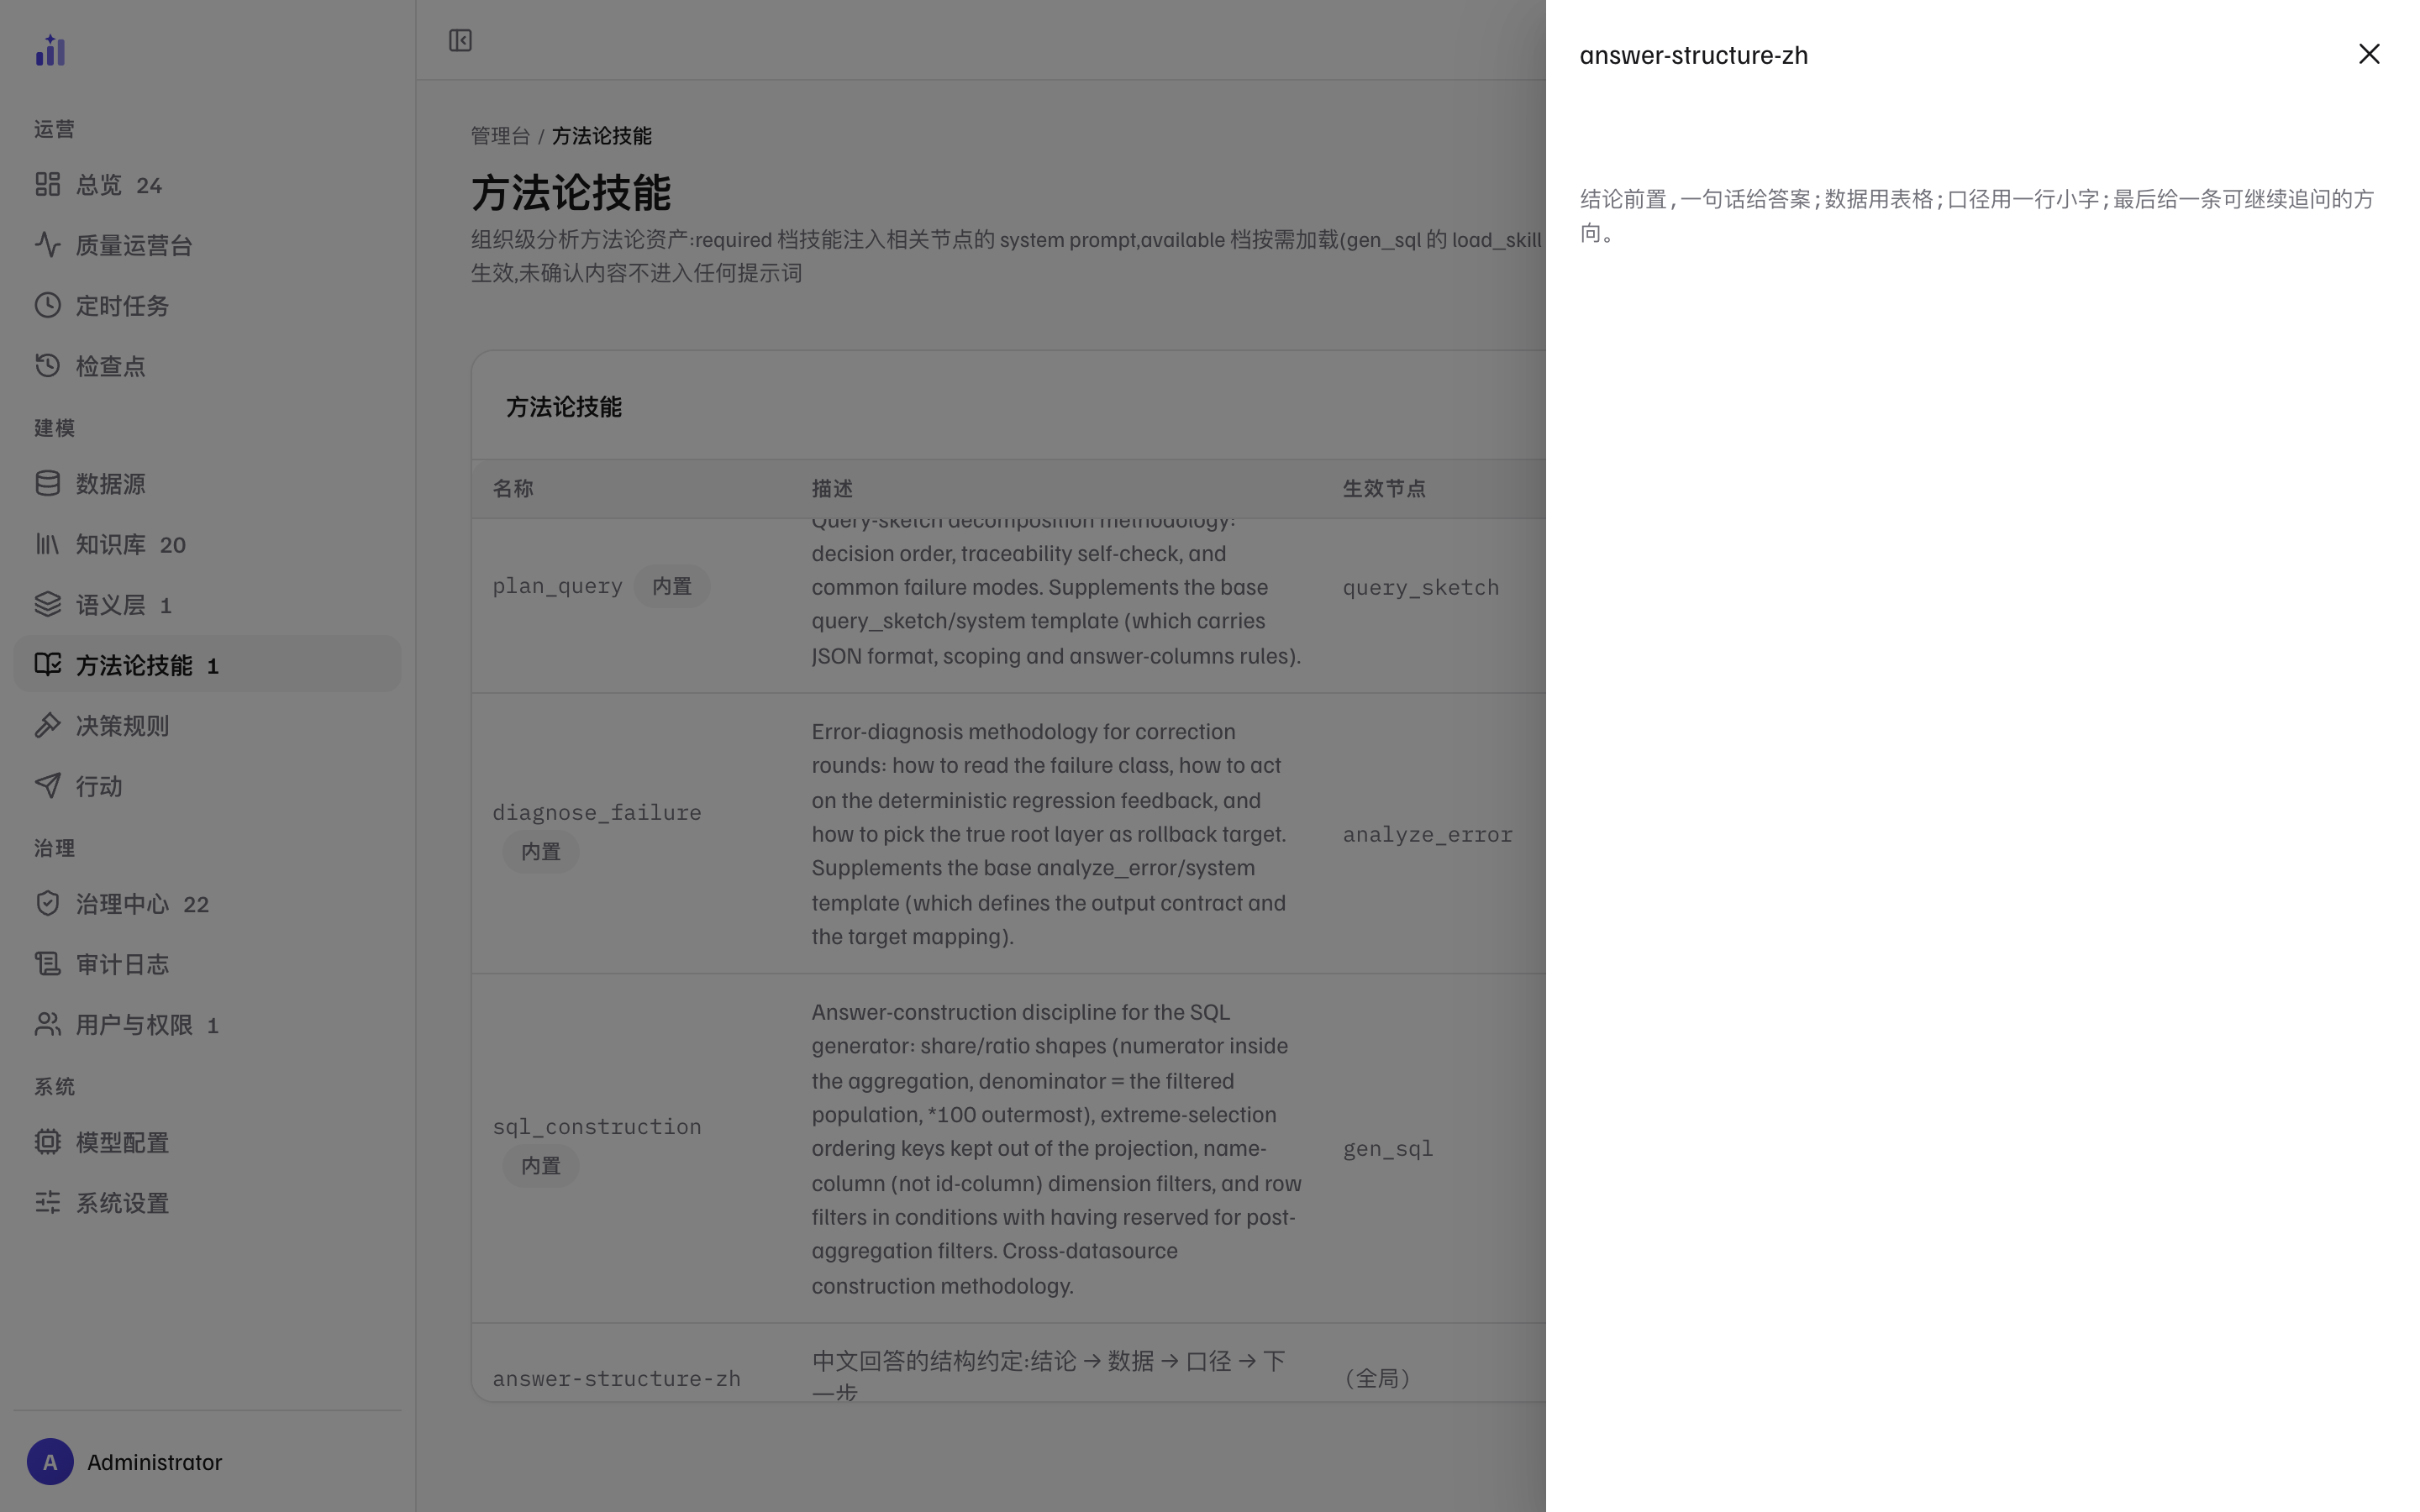 1
2
3
4
load_skill 的可取范围,所以这一屏是「已经生效」的资产)。- 1列表三列:名称 / 描述 / 生效节点——「内置」徽标标的是来源(代码技能,随仓库走);组织技能排在同一张表里,各自带状态徽标(pending / confirmed / rejected / disabled)与相应动作。
- 2生效节点——技能绑定到管线节点:
plan_query → query_sketch、diagnose_failure → analyze_error、sql_construction → gen_sql。required 档注入对应节点的系统提示,available 档只被广告、由load_skill按需取正文。 - 3「(全局)」——没有
triggers.node的技能对所有节点生效(图中answer-structure-zh就是一条中文回答结构约定,作用于整条生成链)。 - 4预览抽屉——打开看到的是正文原文:模型读到的就是这段文字,改一句话就是改一次行为;正文的每次修改自动 git 提交,可回滚。
颗粒停用:停一个资产,不是停一层
治理动作有两个粒度:整层总开关停的是全部 org 资产
(见 深潜 · 扩展与治理);
颗粒停用停的是某一条已确认的资产——status: disabled
是继 pending / confirmed / rejected 之后的第四个状态。不删内容、不退成草案,
只是让它从消费面上消失。
状态机是严格且非幂等的:disable 只接受
confirmed → disabled,enable 只接受
disabled → confirmed;对已停用的再停一次是显式错误,不是无声成功
(把状态机做成幂等,「谁什么时候关的、谁又开的」就从审计史里消失了)。
恢复走 enable 而不是再确认一次——停用是暂停投递,不是撤回确认。
每次变更都是一条 git 提交;自动路径(起草、学习、记忆回写)绝不写入 disabled,
停用永远是管理员的显式动作。
停用后四个消费面同断:节点提示词注入、load_skill 的广告
与按名直取、validator / guard 的执行、以及信封枚举与试跑语料。
消费者共用同一个过滤点(list_org(confirmed_only=True))——
停用一个资产等于四处同时熄灭。按名直取也拒绝这一点值得单说:
点名不是提权,已停用的资产即使被工具按名字精确命中也不会返回正文,
判词还会分方向(「还没确认」与「已被管理员停用」是管理员的两个不同下一步)。
service.py:295 confirmed_only service.py:731 disable skills.py:173 disable
起草:LLM 帮忙,但只到草案为止
管理端可以用 LLM 起草一份 skill。起草用的提示模板按语言分开:
prompts/skills/draft.zh.j2 起草模板 prompts/skills/draft.en.j2 draft template
但起草的产物落在 pending,需要人确认。这个边界和 KB 是同一句话:
模型可以提议,不能决定。
管理端 API
| 端点 | 作用 |
|---|---|
| GET /v1/admin/skills | 列出全部(含 code 与 org) |
| GET /v1/admin/skills/org | 只列 org skills |
| POST /v1/admin/skills/draft | 手工创建草案 |
| POST /v1/admin/skills/llm-draft | 让 LLM 起草一份草案 |
| GET /v1/admin/skills/{name}/body | 读正文 |
| POST /v1/admin/skills/{name}/confirm | 确认——此时才可能进入提示 |
| POST /v1/admin/skills/{name}/reject | 驳回 |
| POST /v1/admin/skills/{name}/disable | 颗粒停用一条已确认的资产(status → disabled,写一条 git 提交) |
| POST /v1/admin/skills/{name}/enable | 恢复(disabled → confirmed)——暂停投递的逆操作,不走确认门,但它本身必须是显式管理动作 |
| POST /v1/admin/skills/{name}/tier | 在 required ↔ available 之间搬——validator 与 guard 走不了这个接口 |
skills.py:84 draft skills.py:102 llm_draft_skill skills.py:131 confirm skills.py:219 tier
前端对应「Skills」页面。修改 tier 是一个值得留意的操作:
把一个 available 的 skill 提成 required,等于给每次生成都加一段固定文本——
确认它真的每次都用得上再提。
这个接口只在 required 与 available 两档之间搬。
validator 与 guard 两档都不在这里切换——
validator 的 mode / severity / targets /
checks 四个字段、guard 的 guard 块(表达式 + severity + targets),
都必须与 tier 在 SKILL.md 里一起手写:升档时这些字段还没被投影到条目上,
降档时又已经在条目上,两个方向都无法在这条路径上校验,所以两个方向都直接拒。
真相是 tier 与那些投影字段只能同一次写入。
校验本体见 service.py:758 set_tier
与 service.py:396 _validate_guard_spec。
继续读
| 想了解 | 去哪 |
|---|---|
| 工具治理与 agent 循环 | Agent 能力总览 |
| KB 的两档门禁(同一套机制) | 知识库 |
| 四个资产面共用的治理形状(pending→确认→版本化→回滚) | 深潜 · 扩展与治理 |
| 上下文预算怎么分配给各信息块 | 查询工作流 · 上下文预算 |
| 模型与 provider 配置 | LLM 网关 |