五个知识文件,按「谁能写」分工
KB 的形态是一组 YAML,人可读可改,也是唯一真源。运行时另有一份 SQLite 镜像
(kb.sqlite,带 FTS5 虚拟表)——但镜像只服务检索,
删掉它可以从 YAML 重建,反过来则不行。
| 文件 | 承载什么 | 写入方 |
|---|---|---|
| schema_notes.yml | 表/列注释、枚举取值、统计画像 | /kb init 起草,人可改 |
| semantics.yml | 语义模型(数据集 / 指标 / 字段 / 关系) | /kb init 起草,人审 |
| examples.yml | 问答对(example)与模板(template) |
/kb init + /kb learn + 反馈回写 |
| rules.yml | 生成时必须遵守的规则文本 | 纯人工——代码里没有任何写入器 |
| lessons.yml | 失败模式与规避方法 | 蒸馏/反馈路径懒创建,两档确认 |
service.py:3 human-editable service.py:530 _parse_file merge.py:54 纯人工文件
同目录下的另外两个文件
它们住在同一个目录、同一套 git 版本管理之下,但不属于上面那五个「知识」文件—— 前者是策略不是知识,后者还不是真源。
| 文件 | 承载什么 | 写入方 |
|---|---|---|
| decisions.yml | 判定规则——同一份语义模型上「算不算有问题」的阈值与条件,供定时任务求值 | 管理端接口整篇替换,落盘前强制 lint |
| semantic_drafts.yml | 硬 MISS 反问产出的待确认语义模型扩展草案 | 反问路径自动写,确认后才并入 semantics.yml |
service.py:1123 save_decisions decisions.py:648 put_decisions manage.py:1129 create_draft
把它们折进「知识」里会糊掉一件事:已确认的事实与待确认的变更 不是同一种东西。判定规则与草案各自有别的消费者,也各有自己的确认门。 判定规则的完整机制见判定规则。
合并逻辑里对它的处理是原样保留,没有任何生成器会产出它。这不是疏忽,是分工:schema_notes 与 semantics 描述的是数据长什么样,可以从库里探测出来;rules 描述的是组织要求怎么算,库里没有这个信息。
把它交给 LLM 起草,等于让模型替组织定口径——那是它不该有的权力。
/kb init:能确定性生成的才生成
初始化一个数据源的 KB,走的是一条确定性优先的流水线。 顺序上先做不花钱的部分,再让 LLM 润色:
- 读活库 schema(表、列、类型)。
- 没有 LLM 凭证时的降级路径:只写一份
schema_notes.yml骨架并返回提示,让人补注释后/kb reload。 - 枚举采样与列统计画像(这一步会真的查库)。
- LLM 起草表/列注释。
- 确定性生成词表与模板——
generate_terms/generate_templates。 - 合成示例,生成语义模型结构。
- LLM 起草同义词与描述。
- 原子写盘:三个文件连续写、中间不 await——避免留下写了一半的 KB。
init_pipeline.py:441 init_kb deterministic_gen.py:460 generate_terms deterministic_gen.py:623 generate_templates semantic_gen.py:210 generate_semantic_document
产出的文件是三个:schema_notes.yml、semantics.yml、examples.yml。
rules.yml 与 lessons.yml 不在其中——
前者的原因是上面说的分工,后者是反馈路径首次写入时才创建。
init_pipeline.py:438 INIT_FILES
这条流水线的产物边界,就是「什么算真实的准确率提升」的边界:凡是 /kb init 不能确定性生成的内容,手工塞进去都不算。特别是把评测集的 gold SQL 抄进 examples.yml——那不是系统变准了,是答案被泄露了。
相应地,模板快径也只用 kind='template' 的条目,因为那是确定性产物,人塞的东西进不了这条快径。
/kb learn:把一次好的问答固化下来
交互式的沉淀路径是半自动的:模型从上一轮对话起草一条示例(外加候选术语), 把草稿展示出来,只有用户明确确认才写盘。
kb_cmds.py:49 _cmd_learn service.py:2487 append_example service.py:2495 append_term
注意这里的确认与后面的「两档门禁」不是同一件事:/kb learn --yes 是当下的人工确认,
写进去就是 confirmed;而自动回写的示例进来时是 pending,需要另一次确认。
区别在来源——人当场看过并点过头的,和系统自己觉得不错的,不该同等对待。
检索:先确定性过滤,再打分
检索的入口在图上(一次问答会并行取示例、教训、术语、指标、实体), 每条通道内部都遵循同一条原则:先用确定性规则排除不可能的,再排序。
graphs.py:470 search_examples service.py:1537 search_examples service.py:1595 _rank_examples
最重要的那条过滤是表锚定:语义链接阶段已经算出了这个问题涉及哪些表
(matched_tables),那么一条示例如果提到了别的表,它就不该被检索到——
哪怕文字上再像。这是一个纯确定性的判断,不依赖任何模型。
service.py:1618 keep service.py:411 _lesson_table_ok
排序分由几路信号合成:术语命中、标签命中、词重叠、表锚定加分, 再乘上聚合/日期模板的折扣(模板类示例的泛化性弱一些,不该压过具体示例)。 与检索通道给出的相似度做融合时,权重是 0.5——这个数字是刻意的中庸值, 因为确定性打分和向量相似度各有所长,谁压倒谁都不合适。
service.py:289 _score_example service.py:462 _fuse_extra_sim
教训的排序多两个因子:投票与时效。 一条被反复验证有效的教训应当排前面,一条很久没被触发的教训应当淡出—— 后者用衰减函数实现,而不是靠人工清理。
service.py:1775 _rank_lessons service.py:445 _recency_factor
镜像与 FTS
YAML 是给人读的,逐条扫描它做检索太慢,所以运行时维护一份 SQLite 镜像。 FTS5 虚拟表是 contentless 的——它只存索引,元数据列标为 UNINDEXED, rowid 与镜像表的主键对齐。
service.py:122 _CREATE_FTS service.py:1180 _ensure_mirror_schema service.py:934 _sync_file_fts
在 PostgreSQL 生产环境里,检索不走这条 SQLite 路径,而是切到 pg_hybrid 后端—— 切换逻辑见 混合检索。两者的分界点是配置与能力探测, 不是数据源类型。
取值画像:让「枚举」这件事有依据
很多问数错误来自取值层的误解:「华东区」到底是 '华东' 还是 'east'?
状态字段有哪些合法值?这些不属于 schema,但决定了 SQL 里的字面量写什么。
画像流程对每个可疑列做一次取值采样,取 Top-K 高频值与频次,连同形状判断
(是枚举?是 ID?是自由文本?)一起合并进 schema_notes.yml 的 stats。
profiling.py:31 TOP_VALUES_LIMIT profiling.py:55 detect_shape profiling.py:195 _probe_top_values profiling.py:253 merge_into_stats
独立脚本 scripts/probe_enums.py 做同一件事,但带两道护栏:
行数上限与超时。因为「对一亿行的大表做全表 GROUP BY」是一个很容易写出来、
又很容易把生产库拖垮的操作。
enum_probe.py:37 DEFAULT_MAX_ROWS enum_probe.py:48 probe_enums
lint:把 KB 的问题在提问之前发现
scripts/lint_kb.py 是专门挑 KB 毛病的静态检查工具
(另有一把专查「抄 gold」的尺子,见本节末尾)。
它检查的都是「不报错但会一直悄悄降低准确率」的问题:
| 类别 | 典型问题 |
|---|---|
| 静态 | 术语 mapping 引用了不存在的列;对 ID 类列写 SUM/AVG;示例 SQL 解析不了、引用了不存在的表、含写操作 |
| 静态 | 纯中文问题(英文检索不可达);列描述为空;教训的 pattern 过长或 note 为空 |
| 需要活库 | schema_notes 里声明的枚举值漏了库里真实存在的值(如 loan.status 少了一个 'C') |
| 需要活库 | 库里存在但 KB 完全没记录的列 |
live_lint.py:19 check_enums live_lint.py:47 check_undocumented_columns
最后一条尤其值得注意:漏掉一个枚举值不会让任何查询报错,
它只会让「状态 = C 的那批」这类问题永远算错——因为编译器认为 'C' 不是一个合法取值。
这类错误没有报错信号,只能靠主动比对发现。
同一套检查还有个写盘前的门禁版本:语义模型的写入路径在落盘之前先跑一遍
lint_semantics,只要有 issue 就 raise——不落盘、不刷新检索镜像,
坏语义根本进不了 KB。命令行上的 lint_kb.py 是给整套 KB 做体检,
这里挡的是「这一次写入」。
scripts/check_kb_anti_cheat.py 做三级比对(字符串归一化、语法树相等、
字面量盲化后结构相等)来抓「KB 里的 SQL 抄了 gold」。检查范围是所有可检索条目——
pending 草稿按项目规则不进检索,所以跳过,但跳过条数每次都打印,
免得「查了 622 条」被读成「全查了」。
判定分两档,这是本脚本最容易被误读的地方:template: true 的条目命中 gold 判
违规(模板是 kb init 确定性生成的,命中只可能是有人塞进去的);
已确认的人工条目命中只告警不判违规(捕获的成功案例本来就允许接近 gold),
但一定会打出来——那条豁免通道同时也是抄 gold 最省事的形状,静默的豁免等于假绿。
零 LLM、零网络、零数据库,已经挂在 CI 上,每个 PR 都跑。
两档门禁:pending 不进检索
所有自动写入的内容默认是 pending。读侧的过滤器是硬的:
待确认的示例直接跳过,教训列表默认只返回 confirmed。
flowchart TB
    Q["提问 → 回答"]:::entry --> D{"这条内容从哪来"}:::entry
    D -- "人当场点头(/kb learn --yes)" --> K
    D -- "自动回写 / 蒸馏" --> P["pending 草稿
示例 · 教训"]:::entry
    P --> G{"管理端确认"}:::gate
    G -- "确认" --> K[("KB YAML
examples / lessons")]:::entry
    G -- "拒绝" --> X["丢弃"]:::entry
    K --> R["检索:先表锚定过滤,再打分"]:::exec
    R --> Q
    classDef entry fill:#71717a14,stroke:#71717a59,stroke-width:1px;
    classDef exec fill:#14b8a614,stroke:#14b8a699,stroke-width:1.5px;
    classDef gate fill:#f59e0b14,stroke:#f59e0b99,stroke-width:1.5px;
    linkStyle 7 stroke:#8b5cf6,stroke-width:1.5px
service.py:617 pending 草稿不参与检索 service.py:1725 confirmed_only service.py:1823 setdefault
| 门禁档 | 内容 | 确认方式 |
|---|---|---|
| 同步确认 | /kb learn 的草稿 |
用户当场看见并加 --yes |
| 异步确认 | 自动回写的示例、蒸馏出的教训、自动偏好 | 管理端列表逐条或批量确认 |
service.py:1900 confirm_pending_lessons service.py:2003 confirm_pending_examples service.py:2221 reject_lesson
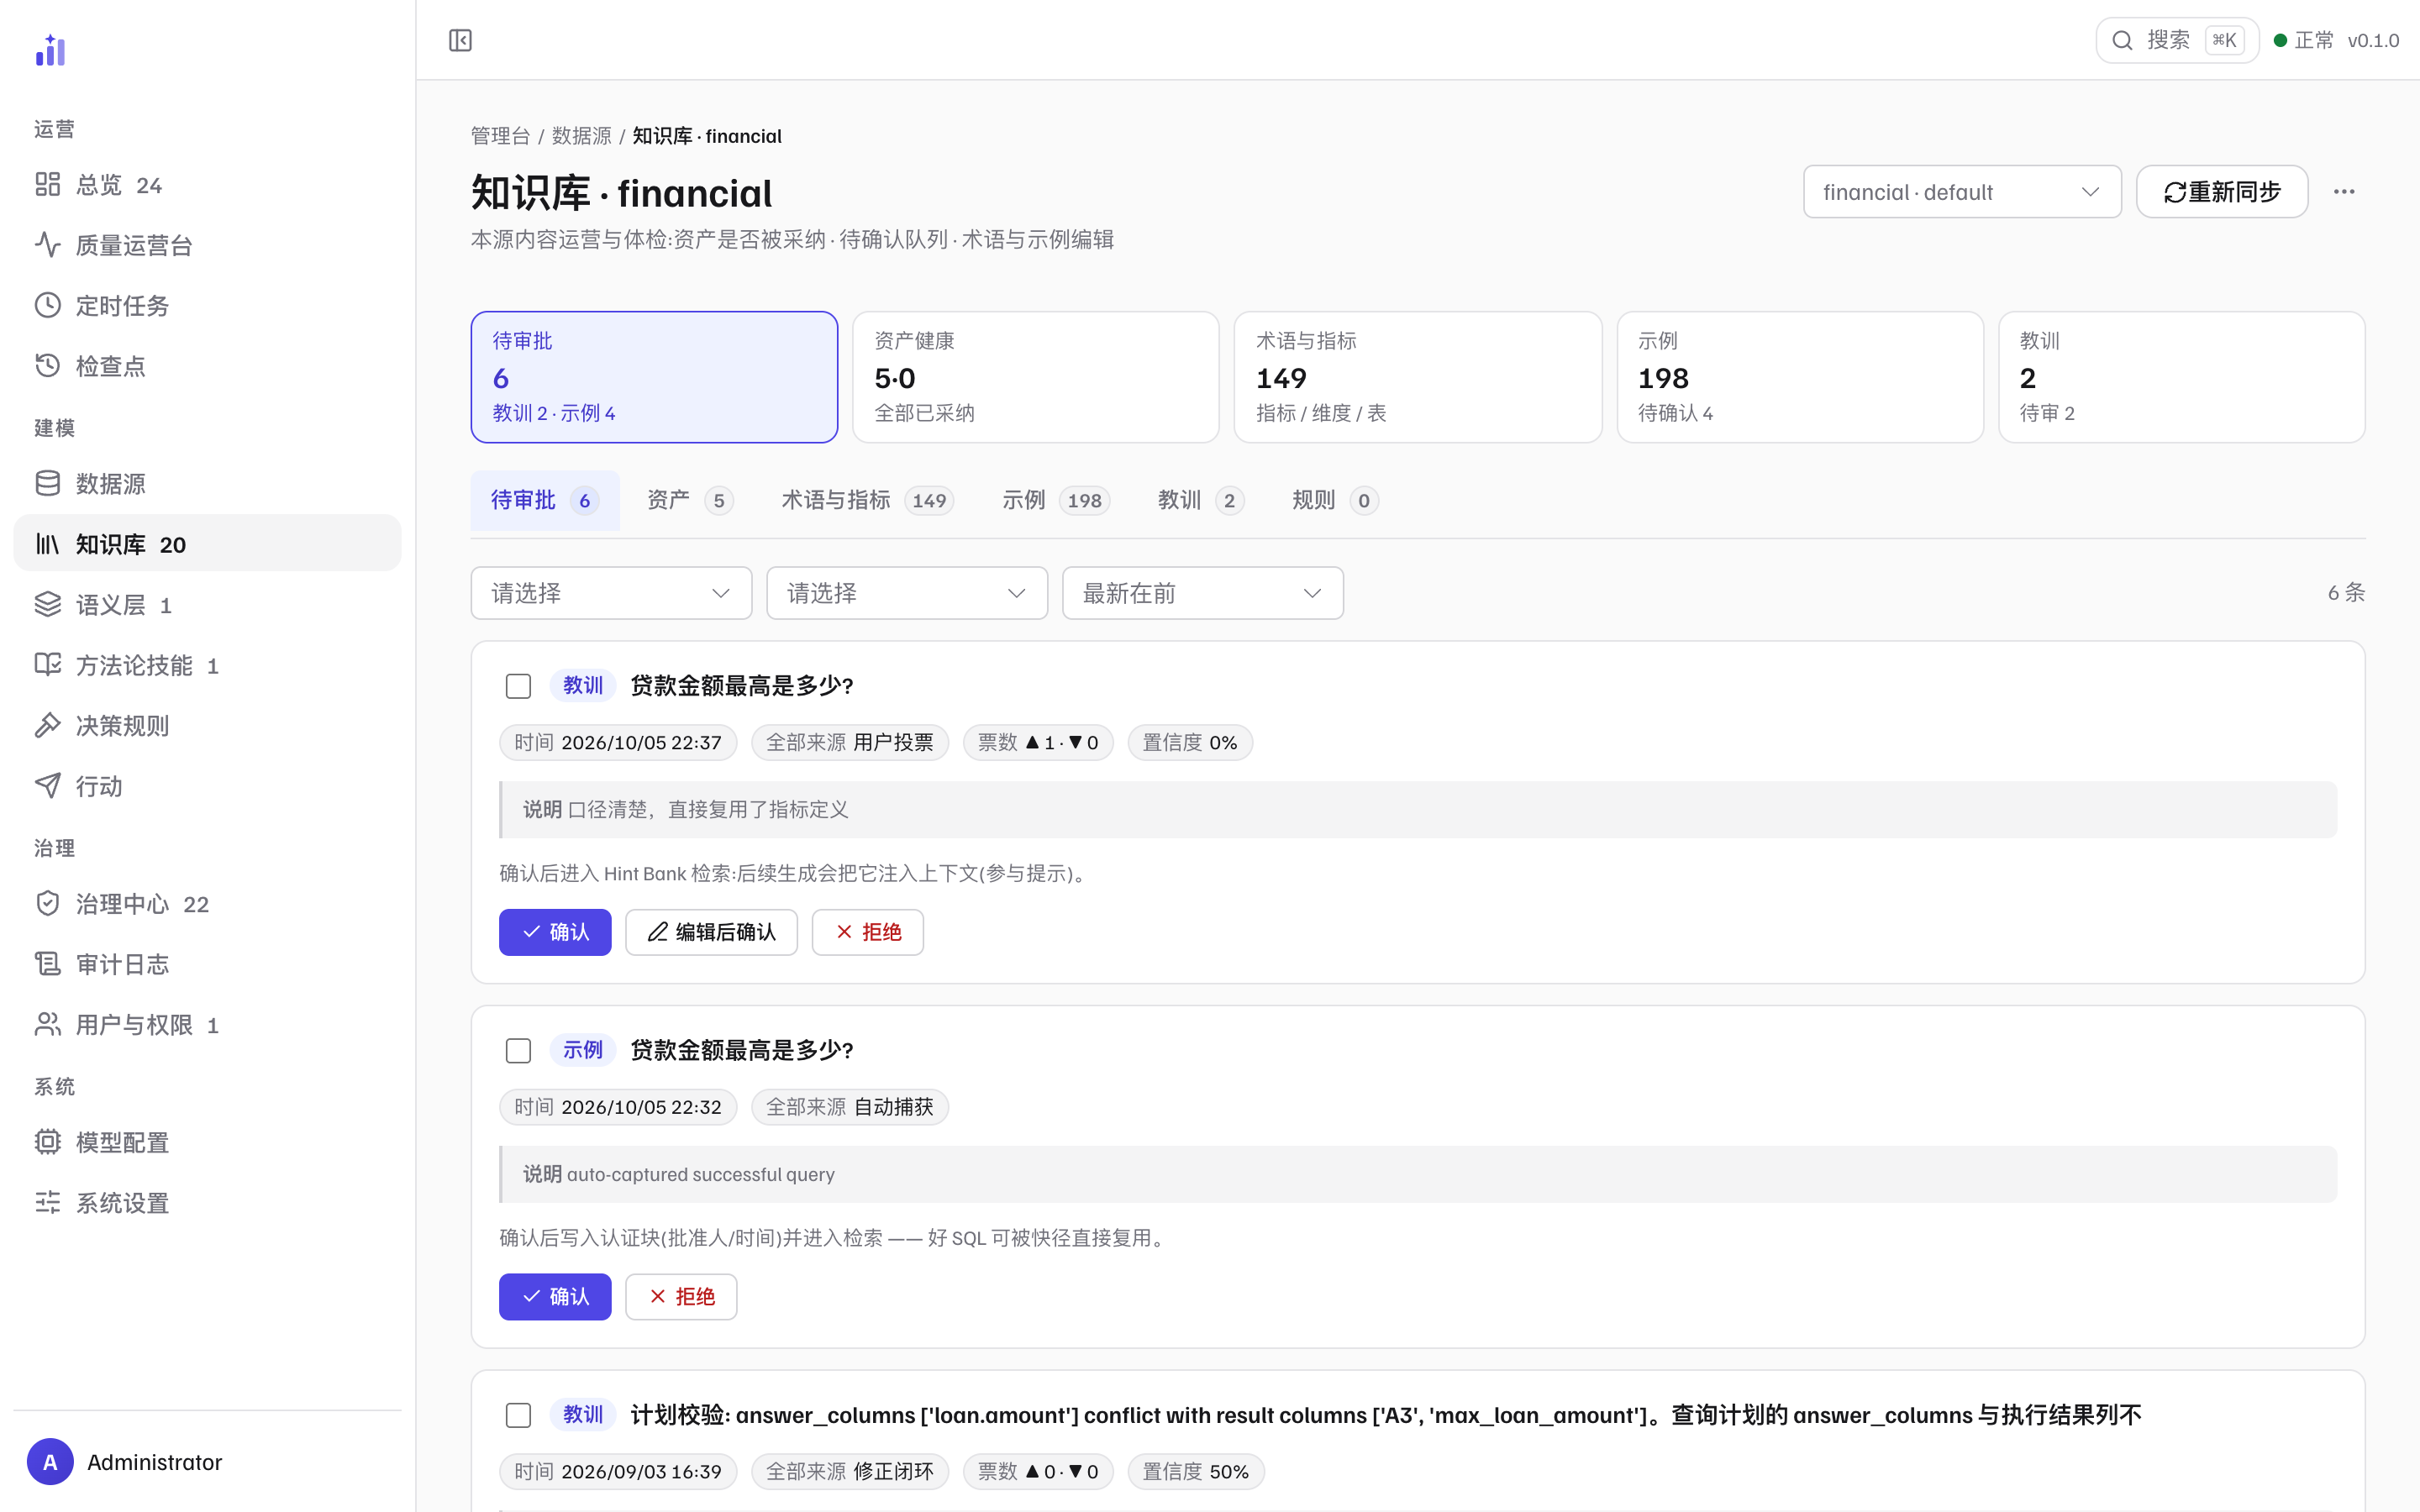 1
2
3
4
- 1待审批 KPI——数字即缺口:6 条待审,拆开是教训 2 · 示例 4。待审的不是「脏数据」,是还没人背书的内容。
- 2tab 行的数字是过滤器——待审批 / 资产 / 术语与指标 / 示例 / 教训 / 规则,每一类各自计数;点哪个数字就按哪一类过滤。
- 3每条待审项带着它是怎么来的——来源(用户投票 / 自动捕获)、时间、票数 ▲1 · ▼0 与置信度(这条 0% 照实显示,不粉饰),下面一行是它的说明;这条教训卡还写明确认后的去向:进 Hint Bank 检索、注入后续生成的上下文。
- 4逐条处置:确认 / 编辑后确认 / 拒绝——确认写入认证块(批准人 / 时间)并进入检索;「编辑后确认」是让确认人先改再背书,而不是先背书再指望有人回来修。
资产治理:这条 SQL 是谁确认的
确认不只是一个布尔开关。示例条目带五个治理维度,
在确认的那一刻逐条写进 examples.yml——与 SQL 同一份文件,随 git 一起回滚:
| 维度 | 取值 | 含义 |
|---|---|---|
| status | draft / certified / deprecated | 治理状态。缺省即 draft——draft 不是「未知」,是「还没人背书」,两者对检索的含义相同 |
| owner | 自由文本 | 这条资产归谁维护 |
| approved_by | 用户名 | 谁背的书。status: certified 时必须与 approved_at 一起在场,缺一就降回 draft——机器不能自己给自己背书 |
| approved_at | 日期 | 什么时候背的书。只降 status、不擦这两个字段,因为它们是修好这条记录唯一的线索 |
| source | human / memory / kb_init / user_feedback | 这条从哪来。存量资产标 kb_init——那是从历史推断出来的,不是谁写上去的 |
governance.py:36 GOVERNANCE_FIELDS service.py:2003 confirm_pending_examples
- 存量条目不迁移:库里已有的几百条示例都在加载期推断成
draft,而不是一次性往盘上写几百行status: draft——那既是没有信息量的写盘,也会让「这条资产被谁验过」的第一次记录变成机器批量盖的章。推断出来的 draft 与写在盘上的 draft 对检索含义完全相同。 - 认证门在写盘之前:确认走一批之前先校验,坏 SQL 会让整批被拒(
ExampleCertificationError),不做「跳过坏的、确认其余的」——部分确认会让 confirmed 这个词本身失去意义。配套的一条纪律(I5):certified必须有人,机器不能自己给自己背书。 _meta来源块:每份生成物落盘时写format/generator/generated_at/digest,回答「我是哪一版生成的」和「生成之后有人动过我吗」。读侧有个版本门:比自己新的格式直接拒绝——按旧解释读一份新格式的文件,产出的不是一个「少读几个字段」的模型,而是一个错的语义模型,它会进编译器、进权威 SQL、进答案。没有_meta的存量文件按 format 0 处理(按当前解释读),所以升级不会一次停摆。
AssetLedger(每条资产被用了几次、成没成、p50 耗时)已实现、有测试钉住,
但没有任何生产构造点——答案是「不猜、不编」:拿不到统计就只报档位那一档,
而不是编一个数出来。另外 status 今天只披露、还没参与检索加权。
统计不写进 examples.yml 是有理由的:那个目录每次写入都触发一次 git commit,高频运行时数据会把资产库的历史淹在统计噪声里,真正想回看的那次「某条 SQL 被谁改坏了」也就找不到了。
一条会咬人的约束:KB 语言要跟着问题语言走
这是一个实测过一次的定性结论,值得写在这里而不是埋在文档角落: KB 内容的语言应当与提问语言一致。用中文 KB 去回答英文问题时, 准确率会明显下降,而且主要缺口不在生成、在少样本检索的命中—— 检索不到对的示例,后面再强也没用。
代码里没有任何地方会强制或警告语言不匹配。它写在约束文档里,靠使用者和 lint 的「纯中文问题」检查来兜。所以如果你换了提问语言,记得配套重建 KB。
相关但不同的一件事:scripts/check_kb_anti_cheat.py 那把反背题的尺子(见 lint 一节)。