判定规则
语义层把「业务口径」写成了机器可读的一份模型。 判定规则是它的第二个消费者:同一份模型,用来回答的不是「这个数是多少」, 而是「这个数算不算有问题」——每天定时跑,零 LLM,产出可重放的证据。 规则可以声明「该怎么办」(建议、响应模板),触发后连同「为什么」 (分析桥的贡献分解)一起进判定历史;每一次判定与上一次的差异,也如实列出来。 再往深一层,判定知道自己有多确定:季节基线构成噪声带,「超出噪声带」可声明为触发的必要条件; 因果升级梯在条件满足时估计净效应,不满足就停在相关,并逐条列出哪条假设没过—— 因果永远是附录,绝不改写触发与否。判定还能被 what-if 回放、被主动扫描提议、被按规则版本回评质量。
为什么让「告警」也走语义模型
常见的做法是给告警单独写一套 SQL,或者干脆让人每天看一眼报表。两种都有各自的代价: 单独写的那套 SQL 会慢慢和真实口径漂开(改了语义模型,告警没跟着改, 于是它开始对旧口径报警);靠人看则会漏,而且漏得没有记录。
这里的做法是让规则用语义模型自己的词表说话:一个 metric、一组 filter、
一个自然语言窗口、一个基线,外加上「什么算超标」的布尔表达式。规则里不出现表名和列名,
所以口径改了,规则跟着改——因为两者读的是同一份 semantics.yml。
service.py:334 DecisionService rules.py:183 DecisionRule
一条规则跑起来是什么样
| 步骤 | 做什么 | 为什么 |
|---|---|---|
| 窗口解析 | 自然语言窗口(「本月」「上周」)→ 具体日期区间,并经同一入口推出基线区间 | 「本月」在用户提问和规则触发时必须是同一个跨度;两处各写一套解析,迟早不一致 |
| 编译 | subject(metric + filter + 时间粒度)编译成权威 SQL | SQL 由编译器产出,不由人手写——手写的 SQL 就是口径漂移的入口 |
| 取数 | 只读执行当期与基期两条查询 | 走的是注册表的受控通道,非 SELECT 一律拒绝 |
| 求值 | 结果行 × 条件 AST → 触没触发、按维度分组各自的判定 | 纯函数,同样的输入永远是同样的结论 |
| 显著性与因果 (声明了才跑) |
触发行过噪声带门(require 时成为触发的一部分);声明了 causal 再尝试反事实估计 |
两段都是事后附加:预算记账、按优先级让路,绝不改变触发与否 |
service.py:568 evaluate_rule rules.py:895 compile_condition
flowchart LR
    R["decisions.yml 规则"]:::entry --> W["窗口解析
「本月」→ 具体日期区间"]:::entry
    W --> B["基期
prev_period / yoy / literal / none"]:::entry
    B --> C["语义编译
subject → 权威 SQL(当期 + 基期)"]:::gen
    C --> E["只读执行"]:::exec
    E --> V["条件 AST 求值
闭集语法,无 eval"]:::gate
    V -- "违反" --> AL["alert + 证据
SQL · 原始行 · 规则摘要"]:::entry
    AL -. "声明了显著性 / 因果" .-> SG["噪声带门 → 因果梯
只降级、不改判定"]:::gate
    V -- "通过" --> OK["ok"]:::entry
    V -- "判不了(Unknown)" --> ER["error 状态:响亮失败
不进通知,但运行历史里显形"]:::err
    classDef entry fill:#71717a14,stroke:#71717a59,stroke-width:1px;
    classDef gen fill:#6366f114,stroke:#6366f199,stroke-width:1.5px;
    classDef exec fill:#14b8a614,stroke:#14b8a699,stroke-width:1.5px;
    classDef gate fill:#f59e0b14,stroke:#f59e0b99,stroke-width:1.5px;
    classDef err fill:#dc262614,stroke:#dc262699,stroke-width:1.5px;
    linkStyle 5 stroke:#f59e0b,stroke-width:1.5px
全程没有模型参与。这不是为了省那点 token,而是因为一个能重放的判定才有资格被追问: 「昨天为什么报红」应该能从输入重新算出来,而不是重跑一次对话看它今天心情如何。
兄弟模块(定时任务的告警表达式)可以承受「算不出来就当没告警」——它的输入已经拿到手了, 最坏结果只是漏一条通知。判定规则不能:一条静默永不触发的定时规则, 和一个健康的规则从外面看完全一样。
所以窗口解析不了、metric 没声明、时间字段缺失,都必须在这一次 run 上留下 error 状态,
而不是降级成「今天没问题」。
条件的表达式语言:为什么不是 eval
条件是一小段布尔表达式,例如 delta_pct > 0.2 and row_count >= 100。
它存在一个任何能写 KB 的人都能改的 YAML 文件里,因此是不可信输入——
绝不过 eval()。实现是一个手写的分词器加递归下降解析器,
语法是刻意收窄的闭集,求值器只能从调用方给的 scope 字典里读值。
| 词 | 含义 |
|---|---|
| current | 当期窗口里的指标值 |
| baseline | 基期窗口里的值;没有基期时是 Unknown |
| delta / delta_pct | 当期减基期,以及它占基期的比例 |
| contribution | 该维度对全部维度 |delta| 之和的带符号占比(仅按维度分组时存在) |
| row_count | 当期查询返回的行数 |
| dim | 正在被求值的那一行的维度标签(仅按维度分组时存在) |
| confidence | 该行的位置分数(0–1):仅当规则声明了 seasonal 且该行算得出时存在,其余情况是 Unknown——「测不出」与「等于 0」在词法上就是两件事 |
函数表同样封死:abs、min、max、pct_change。
变量名或函数名拼错是解析期的错误,由 lint 报出来——而不是变成一个默默为 Unknown
的值,让规则安静地永不触发。这是两条设计里更重要的那条:
把「写错了」和「今天没事」分开。
expr.py:70 VARIABLES expr.py:104 FUNCTIONS
三值逻辑,以及它挡掉的具体那个 bug
求值结果是 通过 / 违反 / 判不了 三种,不是两种。多出来的那一档不是洁癖:
在只有两值的情况下,「缺基期」会让 not (x > y) 求值为真——
于是一条基于「没有数据就报警」写法的规则,会在数据缺失的那一刻反而触发。
Unknown 取反还是 Unknown,而 Unknown 在顶层永远不算触发。
Unknown 是一个单例,它的 __bool__ 会抛异常。也就是说,
代码里不小心写出的 if value: 会当场炸,而不是把第三值悄悄塌成 False——
这类塌陷不会报错,只会让规则少触发几次,没人会注意到。
规则的形状
| 字段 | 取值 | 说明 |
|---|---|---|
| subject | metrics / dimensions / filters / time_grain / limit | 语义查询体,与 POST /v1/semantic/query 同形 |
| window | 自然语言时间表达 | 与提问走同一个解析入口 |
| baseline.kind | prev_period / yoy / literal / none | 基期怎么来;literal 才需要 value |
| scope | aggregate / per_dimension | 判一行,还是逐维度判 |
| emit | any / all / top_k | 逐维度时报告哪些组;top_k 配 top_k 数值 |
| conditions | 列表(AND)或 {all|any: [...]} | 条件表达式 |
| severity | info / warning / critical | 进消息前缀,也进证据 |
| owner_role | 字符串 | 谁认领这条规则——证据里能看出该找谁 |
| recommendation | 字符串(人写) | 「该怎么办」。只能人写:建议是组织做出的承诺,不是模型的猜测;批准人在提案里看到的就是它 |
| priority | 0–3 | 0 = 常规。闭区间而非自由数字——它进通知、进排序、进治理待办,排序语义必须可解释 |
| action | {template, autonomy, params} | 指向一份响应模板 + 自主级别(notify_only / propose,刻意没有 auto)+ 闭集变量改写。见行动与审批 |
| driver_dimension | 维度名 | 触发后分析桥沿哪个维度找主因;缺省用规则自己的分组维度 |
| seasonal | {grain, lookback, mode, k} | v3,噪声带的块规格:grain 空 = 按窗口形状推导(声明了则与窗口硬性对齐,不一致拒绝确认);mode 取 trailing(近期连续块)/ same_phase(去年同期);lookback 默认 12 块;k 是噪声带宽(稳健 z 单位,默认 3.5)。呈现的是一段分布,不是「上期是多少」 |
| significance | {require, min_confidence} | v3,显著性门:require 空 = 只记录不拦;outside_band = 触发必须再超出历史噪声带。min_confidence 是位置分数下限。lint 强制:声明它必须同时声明 seasonal——没有块就没有带,一条永远判不了的规则不该被写进文件 |
| causal | {mode, control, placebo_blocks, tolerance} | v4,因果升级梯:mode 取 auto(尽量升到合成对照)/ did(只做差中差);control 恰一种形态——{dim, value}(对照组是一条维度值,有供体池)或 {filters}(窄口径,至多 L2);placebo_blocks/tolerance 是前窗平行检验的参数。没有 control 的声明被 lint 拦下——梯子永远停在 L1 的声明与不写等价 |
rules.py:37 BASELINE_KINDS rules.py:39 EMITS rules.py:61 PRIORITY_MAX rules.py:88 ActionRef
decisions.yml 带一个 version 字段,当前是
4:v2 加的正是上面这几行(recommendation / priority / action / driver_dimension),
v3 加 seasonal / significance(噪声带与显著性门),v4 加 causal(因果升级梯)。
读到更高版本的文件会直接拒绝——
因为「读得少一点」是静默的:保存回去时会把它不认识的字段悄悄丢掉,
一次整份 PUT 就删掉了新版 Trove 写的规则。拒读好过悄悄少读。
写盘前的 lint 门禁
规则保存时无条件过一遍 lint,不过就整份拒绝写盘。lint 只判不依赖语义模型就能判的事情 (subject 到底能不能编译,由持有模型的服务去判)。几条值得单独说的规则:
| 拦下来的写法 | 为什么它必须被拦 |
|---|---|
| 一条规则里写了两个 metric | 条件词表是单数的(current / delta),第二个 metric 无处可绑。拒绝,好过悄悄只判第一个 |
scope: aggregate 却给了 subject.dimensions |
subject 的维度就是 group by,查询会按组返回多行,而聚合规则去查那个唯一的空标签行——每个变量都读成 Unknown,规则永远不会触发。「安静地死掉」正是这里唯一值得拦的结局 |
条件用了 baseline,但 baseline.kind 是 none |
同上:永远 Unknown 的规则等于没有规则 |
聚合规则上写了 emit |
只有一行,要么触发要么不触发,没有「报告哪几组」这回事 |
per_dimension 却没给维度 |
没有维度可分组 |
rules.py:502 lint_rule kb/service.py:1123 save_decisions
API 也调 lint(为了让报错回到编辑界面),但真正的门在 KbService.save_decisions:
任何写入路径都得过它。所以「绕过 API 直接改文件」不会绕过门禁,
加一个 API 侧的后门也只会挪动强制点,不会取消它。
「一份能落盘但跑不起来的规则,只会变成一条永远不触发的定时任务,没有任何人会发现」—— 这是整个门禁存在的理由。
怎么跟定时任务接上
任务带一个 decision_rule 字段(规则 id)。设了它,这次 run 就不走自然语言管线,
直接按规则求值;设 scan_spec 则是一次主动扫描(见下);
都没设则照常是一次问数任务。几条路的运行记录、告警冷却、通知分发是同一套基建;
字段同时出现时按 decision_rule → scan_spec → 问数管线的顺序取第一个。
runner.py:174 _run_decision jobs/service.py:58 decision_rule main.py:392 装配
运行记录里的 status 有三态:ok / alert / error。
error 的触发条件不是「规则为真」,而是「规则判不了」——它不进通知,
但会在运行历史里显形。这正是上面那条「响亮地失败」的落点。
一次触发还会顺手做三件事,各自独立、各自 best-effort:
判定落入判定历史(下面一节);通知消息缀上分析桥给出的
「主因」行;若规则声明了 action 且自主级别是
propose,则生成一份行动提案。
任何一件失败都只留日志,绝不把一次判得清清楚楚的运行变成 error。
runner.py:330 _notify_message runner.py:390 _record_verdict runner.py:417 _propose_action
触发之后:分析→决策桥
「跌了 12%,为什么?」——判定给出「有问题」,桥给出「为什么」。
监控类产品的告警通常止步于「阈值 + 数字」;这里在触发的那一刻
把分析引擎接上去,产出一份确定性的摘要(零 LLM):
谁推动了变化(top_components)、分解的诚实残差(residual)、
驱动器树证据、可复算的 SQL,以及哪一步没做成(degraded)。
三条纪律值得单独说:
| 纪律 | 为什么 |
|---|---|
| 只在触发时跑 | 判定是常态,分析是例外——不能让每条不触发的规则都背两次额外查询。未触发,桥零成本 |
| 预算硬上限(≤ 4 条查询) | 超预算不是错误,是事实:记账 query_budget_exceeded 并交出已拿到的部分——响亮,不阻断 |
| 不适用 ≠ 失败 | 指标表达式不可分解(单叶子)、没有可解析的时间字段——桥对这条规则「没有话说」,返回空;只有该做而没做成(编译失败、SQL 报错)才记 degraded |
摘要进证据的 analysis 块,同时被压成一行通知文案:当贡献最大的
组件带着占比时,通知里会出现「主因:region=华东(贡献 62%)」这样的尾行;
桥没话可说时这行不出现——一行「主因:—」比没有更糟。
bridge.py:144 run_bridge bridge.py:126 primary_driver_line bridge.py:51 MAX_BRIDGE_QUERIES
桥的维度与时间字段解析用的是判定路径编译时的同一份锚定数据集。 拿错锚定的后果不是报错,而是桥静默退化成「永远不适用」—— 一条永远不响的附录,与「这条规则没什么可分析的」从外面看毫无区别。
显著性:噪声带,与「判不了」的完整词表
两周前的数字和本周差多少算「跌了」?两条数据点答不了这个问题——
没有波动概念,任何微小抖动都会被读成信号。所以 v3 给规则加了
seasonal 块规格:把历史切成块序列,
用它们的分布给「正常波动」画一条噪声带。
带的构造是纯 stdlib 的确定性统计:中位数定中心、MAD×1.4826 定尺度、
bootstrap 分位区间,样本自相关修正后的 n_eff 计有效样本
(纯 stdlib:可复算、可种子重放)。判定侧只说纪律:
| 纪律 | 含义 |
|---|---|
| 位置分数不是概率 | confidence = (|z|−k)/k 截断到 [0,1]:0 = 恰在带缘、1 = 两倍阈值;无分布假设,不输出 p 值 |
| 块数不足不予确认 | 块数 < 8(MIN_BLOCKS)直接记 insufficient_n——样本那么少,显著性只会变成噪声放大器;块数 < 12 额外挂 low_n 标 |
| 「判不了」是完整词表 | 不是布尔值:每条判不了都有一条具名原因(见下表),绝不折算成「没事」或「有问题」 |
当规则声明 significance: {require: outside_band},噪声带从记录升级为
触发的一部分:规则级 triggered = any(行触发 ∧ 过门)。
而 require 生效时如果带压根算不出来(没有历史块、历史恒定、
时间字段缺),这次运行直接记 error——要求噪声带兜底的规则,
宁可报错误运行,也不静默放行。
| reason | 人话 |
|---|---|
| no_current_value | 本期值缺失——没有可比的数 |
| no_band | 没有历史块,带建不出来 |
| no_data / zero_scale | 带自身退化:无数据 / 历史恒定(稳健尺度为零) |
| band_unavailable | 带不可用而未归类——兜底,不冒充某个具体原因 |
| insufficient_n | 块数 < 8(MIN_BLOCKS 硬门) |
| within_band | 判了,落在带内——这是结论,不是失败 |
| confidence_unavailable | 位置分数算不出 |
| below_min_confidence | 在带外,但强度不够规则声明的下限 |
查询花销显式记账:DecisionBudget 给每段划份(判定 2 / 显著性 2 /
因果 4 / 桥 4,总上限 12),超额按优先级让路并记进
evidence.budget——让路是可见的事实,不是无声的降级。
同一套噪声带也用在分析回答里(「本期 vs 历史噪声带」一节),
outside_band 同样是三态:超出 / 带内 / 判不了,判不了的原因同样具名。
significance.py:61 build_band_payload significance.py:85 gate stats.py:199 band stats.py:37 MIN_BLOCKS service.py:223 行卡 gated 与规则级 triggered budget.py:34 DecisionBudget output.py:539 噪声带行
因果升级梯:相关是默认,因果要过条件
「A 涨了,B 也涨了」是相关;企业想知道的是「这个变化带来了多少净效应」。
但因果不能靠声明,要靠设计。声明了 causal 的规则,
在噪声带之后走一条升级梯:每一级先查条件清单,过不去就停在上一级,
并逐条列出哪条假设没过——「无法检验」被写出来,而不是省略。
| 级 | 方法 | 需要什么 |
|---|---|---|
| L1 | 相关:确定性贡献分解 | 永远可用——分解恒等式,不主张因果 |
| L2 | 差中差:ATT = 处理组前后差 − 对照组前后差 | 声明的 control 可构造对照组;前窗平行检验(placebo)通过;只报效应量与是否跨零,不贴显著性标签 |
| L3 | 合成对照:供体等权平均构造反事实 | 仅 mode: "auto" 且有 {dim, value} 供体池;前窗拟合诊断差 → fit_too_poor 拒绝升级 |
三条纪律:逐条假设带体检——每条结论附 assumptions 数组,
每条带 checked 标记(通过 / 不通过 / 无法检验);
不满足就诚实降级——停在 L1 时说明哪条没过、实测值多少;
因果永远是附录——只进 degraded 附注,绝不改变 triggered,
绝不上抛。相关与因果在输出上的区别,是渲染层的一等公民。
causal.py:305 ladder_decision causal.py:188 did_se causal.py:213 donor_counterfactual causal.py:87 LADDER_ASSUMPTIONS service.py:903 _causal_stage
What-if:在当时的数字上重放
「阈值改到 8% 会怎样?加一个过滤条件还触发吗?」——回答这些问题不必重跑业务库:
POST /v1/admin/decisions/{rule_id}/simulate 把最近一条判定留下的数字行
(或调用方直接给的行)灌进同一个 judge 纯函数,当场重判。
判定是纯函数,重放给出的是确定答案,不是估计。
两条刻意的约束:零业务库查询——数据来源只有判定证据行与调用方入参两条路,
「再查一遍库」这第三条路被有意排除(那会把「当时为什么响」换成一个新问题「现在会不会响」);
显著性只重放不重算——噪声带是当时判定的产物,跟着一起重放,
保证变化的只有一个变量。若规则在判定之后被编辑过,结果带 source.stale = true
与 degraded 注解——重放的是旧规则的数字,这件事自己先说出来。
带 impacts 的规则还能模拟触发后的影响树:
可分解的节点按贡献传播,不可分解的节点标 not_modeled——不装能算。
whatif.py:146 simulate_rule whatif.py:245 impact_summary decisions.py:429 POST /simulate
主动扫描:先找异常,再问要不要盯
上面的规则是「人先想到问题,写成规则」;主动扫描是反向的:
给定时任务一个 scan_spec(度量 × 维度 × top_k),
引擎逐条算块序列、画噪声带、找超出噪声带的异常,按 |z| 降序取前几名。
扫描是确定性的,零 LLM。
找到的异常不直接成为规则:落进 decision_drafts.yml 草稿,
管理端确认后才写进规则文件——自动内容永远不绕过确认门,
与 KB 的 pending 草稿是同一条纪律。
可选的 LLM 假设层(默认关,成本考虑):LLM 提假设(「哪条度量 × 哪条维度可能异常」),
引擎逐条验证。边界划得很清——解析期先验证引用(度量 / 维度必须真实存在),
验证不过根本不发查询(LLM 创不出不存在的度量);每条假设恰好一行裁决,
取值闭集 supported / refuted / unverifiable / no_data,
unverifiable 带原因(如 budget_exceeded)——没有静默丢弃;
裁决由引擎算数,LLM 只写 rationale,渲染永远带 source: "llm" 标。
scan/service.py:350 scan_and_draft scan/scanner.py:63 rank_findings scan/hypotheses.py:144 propose scan/hypotheses.py:290 verify jobs/store.py:58 scan_spec 列
质量回评:按规则版本分桶
一条规则吵不吵、准不准,不该靠印象。GET /v1/admin/decisions/quality
把每条规则的历史按 (rule_id, rule_rev) 分桶——
rule_rev 是逐规则的版本,同文件里改别人的规则不污染它的账本;
版本对不上的老判定归入 rev_unknown 桶。
每个桶里是四类结局计数:有效 / 无可辨识变化 / 测不了 / 错误, 另有触发率与测量总数。比率只在分母够的时候给——已裁决 ≥ 3 才报有效率, 判定总数 < 12 整桶挂「样本不足」标。宁可说「样本不足」, 也不给出「一条测量 = 100% 有效」的伪精度。
score.py:109 score_history score.py:37 MIN_EFFECTS quality_report.py:48 build_report decisions.py:551 GET /quality
判定历史:每个版本都被留下,相邻两次被对照
每次判定写一条不可变的判定记录:判了什么、依据哪些数字、
哪一版规则(rule_digest)。没有编辑、没有回滚——
判定是关于某个时刻的陈述(「2026-10-01 这次聚合判定说 X」),
改一条判定就是改历史,而证据存在的全部意义,是让后来的分歧针对记录争论
而不是针对一行可变的今天。
判定按变化触发,所以最有用的邻居是上一次判定。 「相邻 diff」是纯函数、且从不存储:每次读的时候由两条记录现算, 并且对缺字段的旧记录(或行数被截断的记录)优雅降级为「看不出来」, 绝不发明一个变化。它回答的问题很具体:
| diff 说的 | 含义 |
|---|---|
| rule_digest_changed | 整份 decisions.yml 在两跑之间被改过——它能解释其余一切,所以单独点名 |
| rule_rev_changed | 这条规则本身被改过(逐规则版本,不受同文件其他规则编辑影响)。管理台展示时 rev 优先、缺席退回 digest——两把尺:digest 动说明文件动过,rev 动才说明它动过 |
| trigger: fired / cleared | 本次从「平静」转为触发,或相反 |
| groups: fired / cleared / jump | 逐维度:某个组开始触发、停止触发,或变化幅度突跳(|Δpct 差| ≥ 10 个百分点——一个写在常量里的展示阈值,不是统计断言) |
| groups: appeared / vanished | 某个组在两次之间有/无——缺席本身也是信息 |
| status_change | ok / alert / error 之间的迁移 |
判定存储比运行记录留得更精简(每档证据行 50 vs 200), 并把「截断过」作为显式标记存下来——因为卡掉的那几行恰好是 diff 要读的东西, 剪掉就得承认剪过。
verdicts.py:46 VerdictRecord verdicts.py:180 diff_verdicts verdicts.py:42 MAGNITUDE_JUMP verdict_store.py:124 VerdictStore
管理台的「判定规则」页里,每条规则一行「判定历史」抽屉:最近的判定逐条列出, 相邻 diff 以一组固定词汇的芯片呈现(窗口边界、与上次相同、规则已修改、 转为触发/转为平静、幅度突变、新增分组、分组消失), 点开任意一条能看到它当时的完整证据与主因分析。词表是闭集—— 「无前次可比」也是一枚芯片,而不是一个消失的区块。
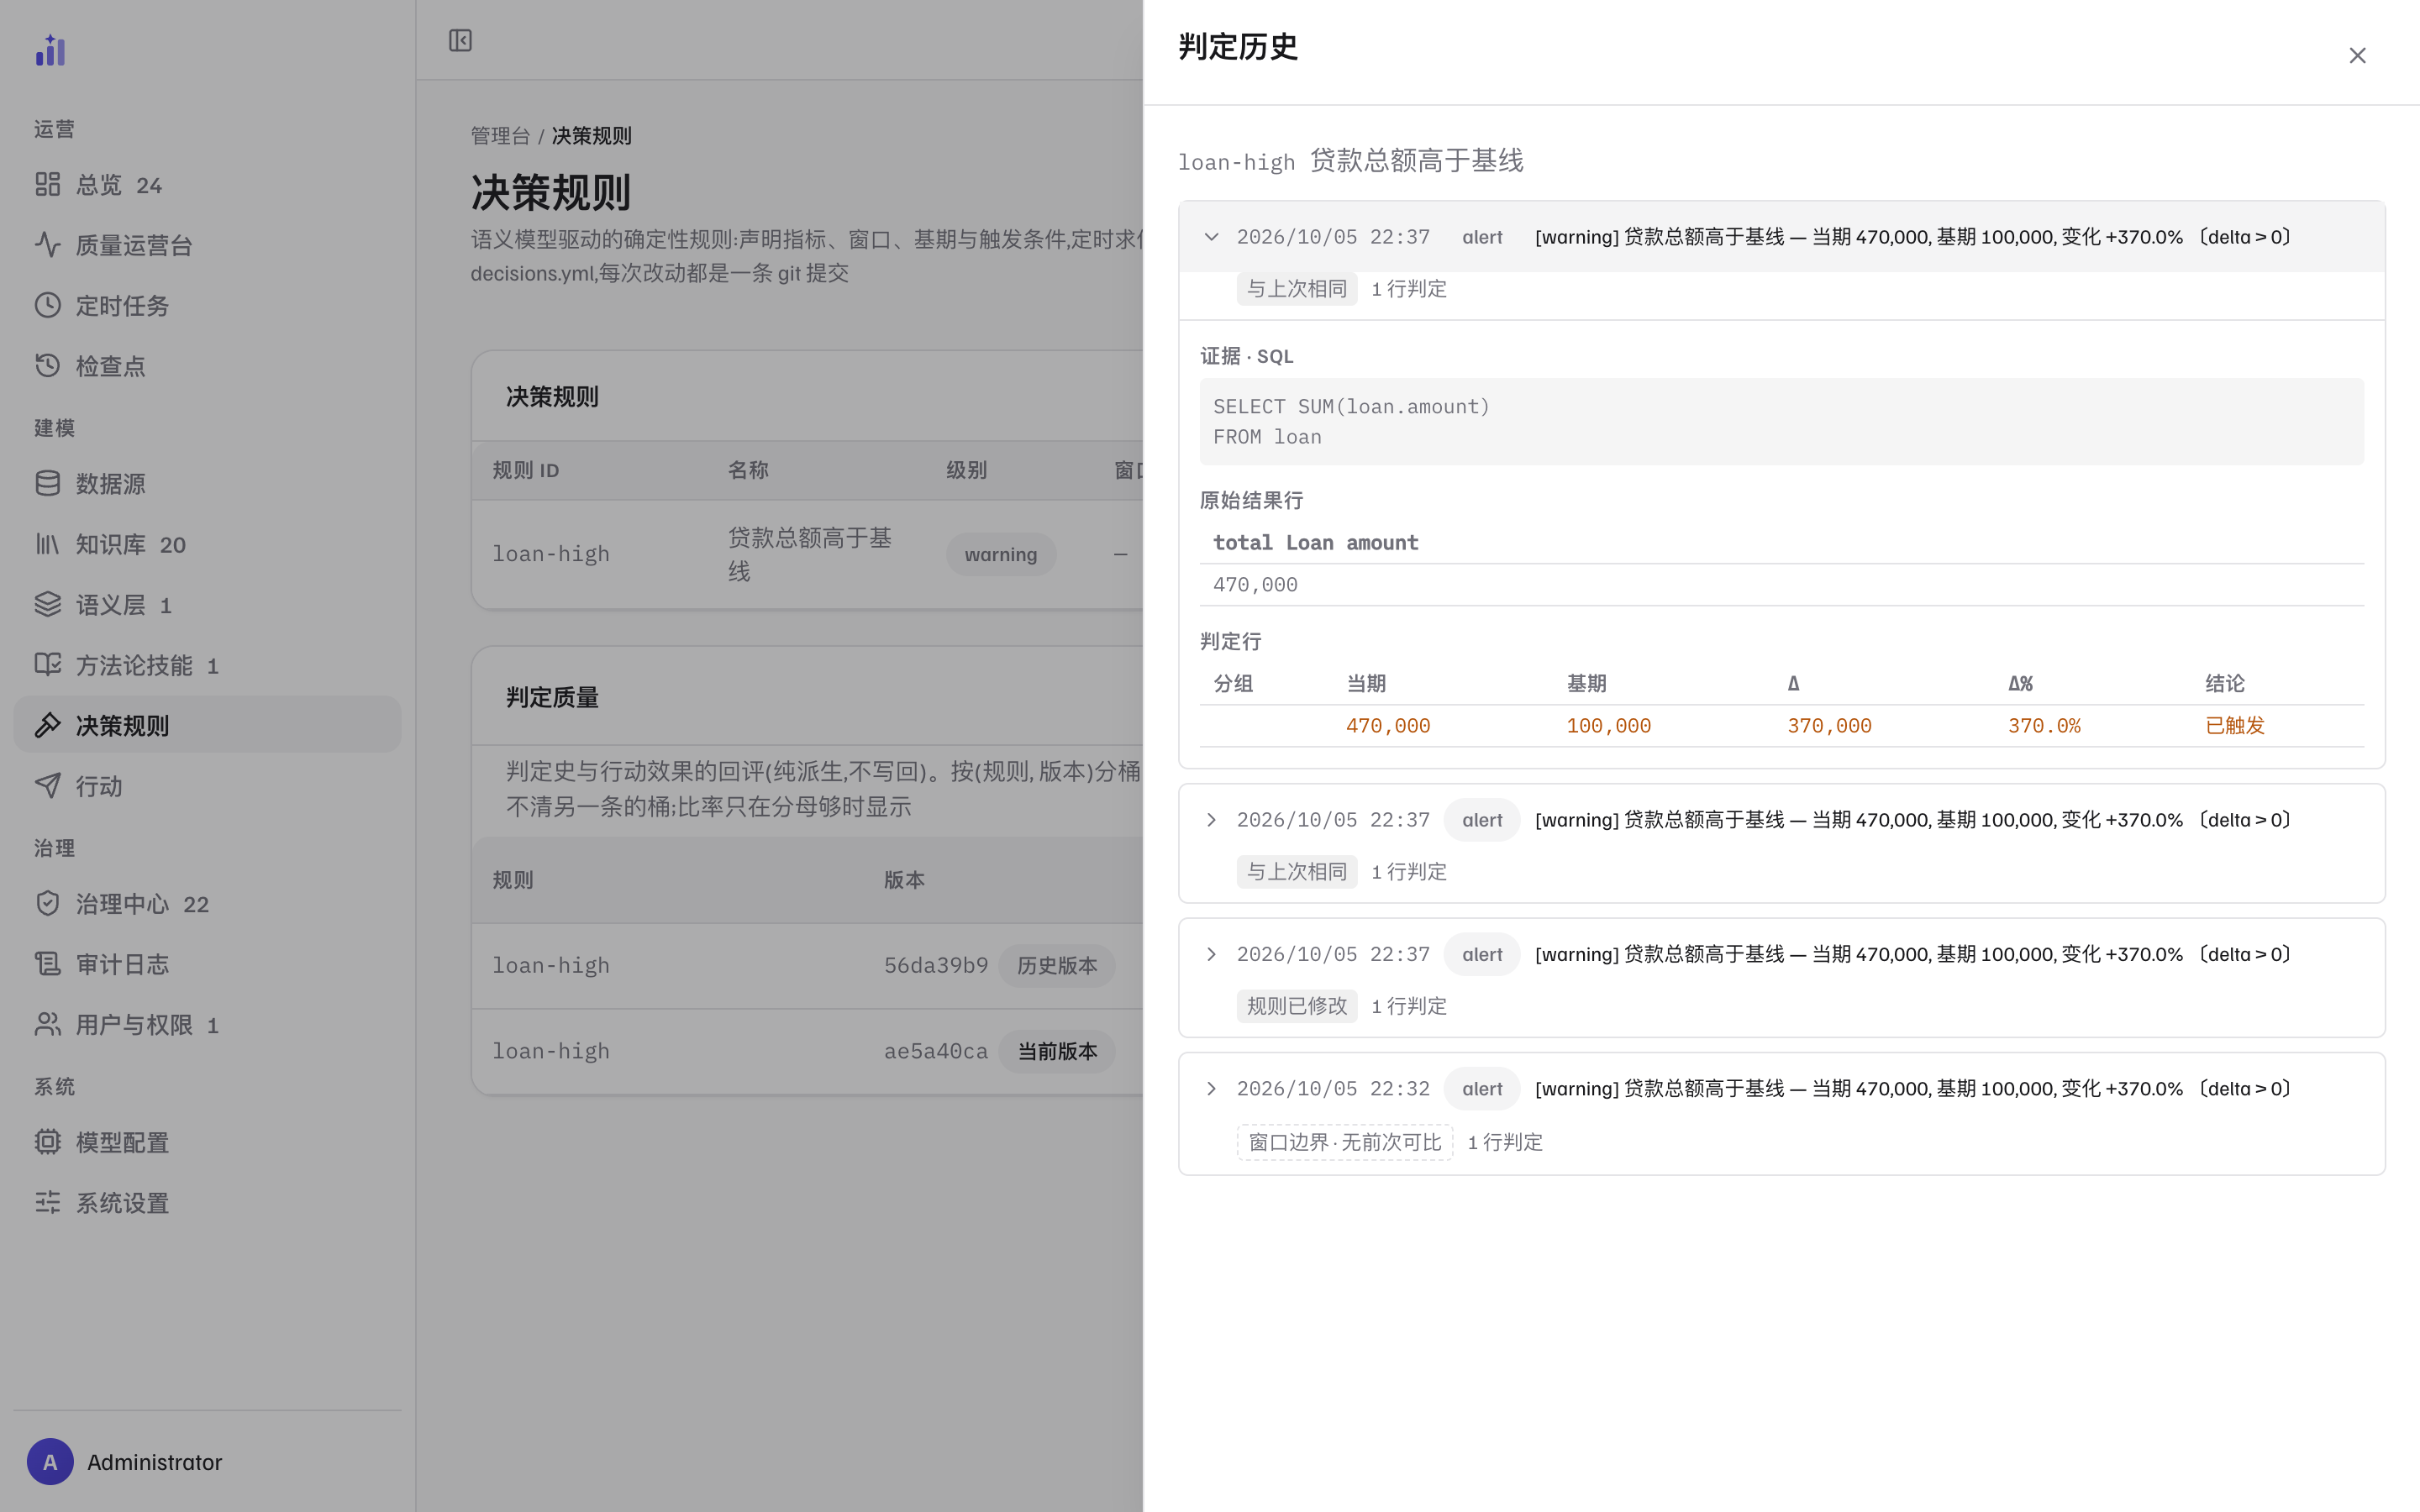 1
2
3
4
- 1一条判定与它的 diff 芯片——时间、状态章(
alert/ok/error)、消息内容;下面这枚芯片是相邻 diff 的一句话:图中这条是「与上次相同」(与上一条判定逐项一致);有变化时换别的词——「规则已修改」「转为触发」等,必要时并排出现。 - 2展开的证据——当时实跑的 SQL 与原始结果行。本规则的基线是字面量(
literal 100000.0),所以只有当期一条查询;基线来自查询时这里会是两条。判定不可编辑,这是它被判定时的数字原样。 - 3判定行——分组、当期、基期、Δ、Δ% 与结论(已触发 / 未触发)逐项列出;维度不足时这一行也照实呈现,不补造。
- 4更早的判定——逐条同样带芯片:「与上次相同」「规则已修改」「窗口边界」(最早一条前面没有可比的——与「相同」是不同的两块,词表里各有一枚芯片)。
证据:一次触发留下了什么
触发的判定会带一份证据进运行记录,逐项都落到具体字段上:
| 字段 | 具体是什么 |
|---|---|
| 规则 | id、名字、severity、负责角色,以及 rule_digest——decisions.yml 的字节摘要,说明这一版判定出自哪一版规则;B2 起另有 rule_rev(逐规则的版本),质量回评按它分桶 |
| 区间 | periods.current / periods.baseline 两个具体区间,加基期类型;times 里另有锚点日期与求值时刻 |
| SQL | 当期与基期各自的编译产物,连结果列名与原样行一起 |
| 时间 | 窗口是按哪个字段切的(time_field)——换一个字段就是另一个口径 |
| 结果 | 截断到 200 行,并显式带 truncated 标记与完整行数,而不是悄悄丢行 |
| 每组 | 一行:dim、current、baseline、delta、delta_pct、contribution、triggered(声明 seasonal 时另有 confidence 与 gated),以及 matched——只有真的触发的组才列命中的条件,否则半匹配的组看起来也像发了 |
| 显著性 | 声明 seasonal 时:噪声带(band + bootstrap 区间 + n_eff + low_n)、当期的 z 与位置分数、gated 与否决原因;require 时它就是门 |
| 因果 | 声明 causal 时:梯级(L1 / L2 / L3)、效应估计与假设清单(逐条带 checked)。永远不改变 triggered |
| 预算 | budget 账本:{limit, used, by_stage, yielded}——哪一段用了多少、在哪里让了路,一目了然 |
| 分析 | 触发时分析桥的摘要(analysis):贡献分解、残差、驱动器树、可复算的 SQL,以及没做成的部分。不适用则整块缺席,而不是一块空壳 |
| 来源 | 数据源名,以及语义模型的版本(model_version) |
service.py:63 MAX_EVIDENCE_ROWS
因为判定 run 的证据就是它的审计轨迹。没有摘要的话, 一旦阈值被改,「这条是当时按 10% 判的」这个问题就永远答不出来了—— 你能看到它触发过,但看不出它当时依据的是什么。
失败也一样记摘要:「哪一版规则开始报错了」是它出问题时的第一个问题。
只有被判定为触发的组才会列出它命中的条件。这条是为 all 模式加的:
否则一个只满足一半条件的组,看上去也会像「它触发了」。
规则存在哪
.trove/kb/<datasource>/decisions.yml——在 KB 树里,也就是在
知识库那套已经受 git 管理的目录里。每一次规则变更都是一个可 review 的提交。
写回时显式只暂存这一个文件,避免把别人还没提交的 semantics.yml 改动卷进这次提交。
kb/service.py:1047 load_decisions
但规则刻意不进检索镜像。混合检索索引的是「和提问有语义相关性的内容」, 而规则跟用户问什么没有关系——让它进索引,只会被词面命中,白白占掉上下文预算 (见混合检索)。这是「同类的东西不必放在同一个篮子里」的一个例子: 它们同属 KB 树,但不同属可检索语料。
管理端接口
| 方法 | 路径 | 作用 |
|---|---|---|
| GET | /v1/admin/decisions?datasource= | 列出规则,带 lint 问题、「哪些任务引用了它」,以及每条最新一次判定的摘要 |
| GET | /v1/admin/decisions/raw | 整份 decisions.yml 原文,给编辑器用 |
| GET | /v1/admin/decisions/{rule_id} | 单条规则 + 它自己的 lint 问题 |
| GET | /v1/admin/decisions/{rule_id}/verdicts | 该规则的判定历史,相邻记录已带好 diff |
| GET | /v1/admin/decisions/verdicts/{verdict_id} | 单条判定记录,含完整证据与主因分析 |
| POST | /v1/admin/decisions/{rule_id}/simulate | what-if 重判:在最近一条判定的数字(或调用方给的数字)上重放,零业务库查询 |
| GET | /v1/admin/decisions/quality | 按 (rule_id, rule_rev) 分桶的质量回评 |
| GET · POST | /v1/admin/decisions/drafts /drafts/{id}/confirm · reject | 主动扫描落下的规则草稿;确认之前不进规则文件 |
| PUT | /v1/admin/decisions | 整份替换:结构化 rules 或原始 text 二选一 |
decisions.py:130 list_decisions decisions.py:63 _verdict_brief decisions.py:333 list_verdicts decisions.py:299 get_verdict decisions.py:648 put_decisions
接口刻意是读多写整份的:没有按条 PATCH。理由是并发编辑同一个文件的合并问题—— 整份替换让写入是原子的,也让那次 git 提交成为这次修改的精确记录。
删除一条规则只能靠整份替换(把 rules 里的它去掉)。所以空文档是合法的:
它是删掉最后一条规则的唯一途径。但列表接口会额外插一句「这个数据源没有声明任何规则」——
读者需要知道「没有任何东西被盯着」,而不是把空列表读成「一切正常」。
列表和单条接口都会回传哪些定时任务引用了这条规则。 删掉一条仍被任务引用的规则,留下的不是「这个任务安静了」,而是「这个任务每次 tick 都失败」。