语义层
数据能力的第一组。语义层回答的是: 一句话问题里哪些部分可以被权威地翻译成 SQL,哪些不能。 能翻译的部分不交给模型,不能翻译的部分明确说出来——这一页讲这套判定是怎么做的。
语义层的职责边界
语义模型存在 semantics.yml 里,采用 Apache OSSIE 核心规范的
semantic_model 结构(datasets + metrics,表达式按方言声明、表名限定)。
这是唯一被读取的格式:更早的扁平 terms: 写法已经不再读取——
解析出来是零条,只留一条迁移警告。手里有旧格式的库,重跑一次
/kb init --overwrite 再生成即可。
先把一件事说清楚,因为这里最容易误会:语义层不是「更好的提示词」。 提示词影响的是模型输出的概率分布,而语义层做的是编译——把结构化的计划 确定性地翻译成 SQL,同一份计划永远得到同一条 SQL。
| 语义层做 | 语义层不做 | |
|---|---|---|
| 指标口径 | 把指标展开成它声明的表达式 | 猜一个没声明过的指标该怎么算 |
| 表关联 | 按声明的 relationship 求 join 路径 | 在两条都说得通的路径里选一条 |
| 行集正确性 | 识别会放大/复制行的 join,拒绝它 | 生成一条「大概对」的 SQL 让人自己发现 |
| 权限 | 把声明的行过滤谓词注入每个引用该表的查询 | 替代数据库侧的只读角色 |
语义模型的结构
语义模型由四类构件组成。它们的关系是:数据集提供表,关系提供边, 字段提供可用的列,指标提供算法。
models.py:354 SemanticModel models.py:82 SemanticMetric models.py:119 SemanticField models.py:190 SemanticRelationship
关系上有一个字段值得单独说:fan_out。它在模型里是显式声明的,
而不是运行期推断的——因为「这条边会不会放大行数」是关于业务的判断,
数据库的元数据里没有这个信息。
models.py:222 fan_out models.py:221 cardinality
 1
2
3
4
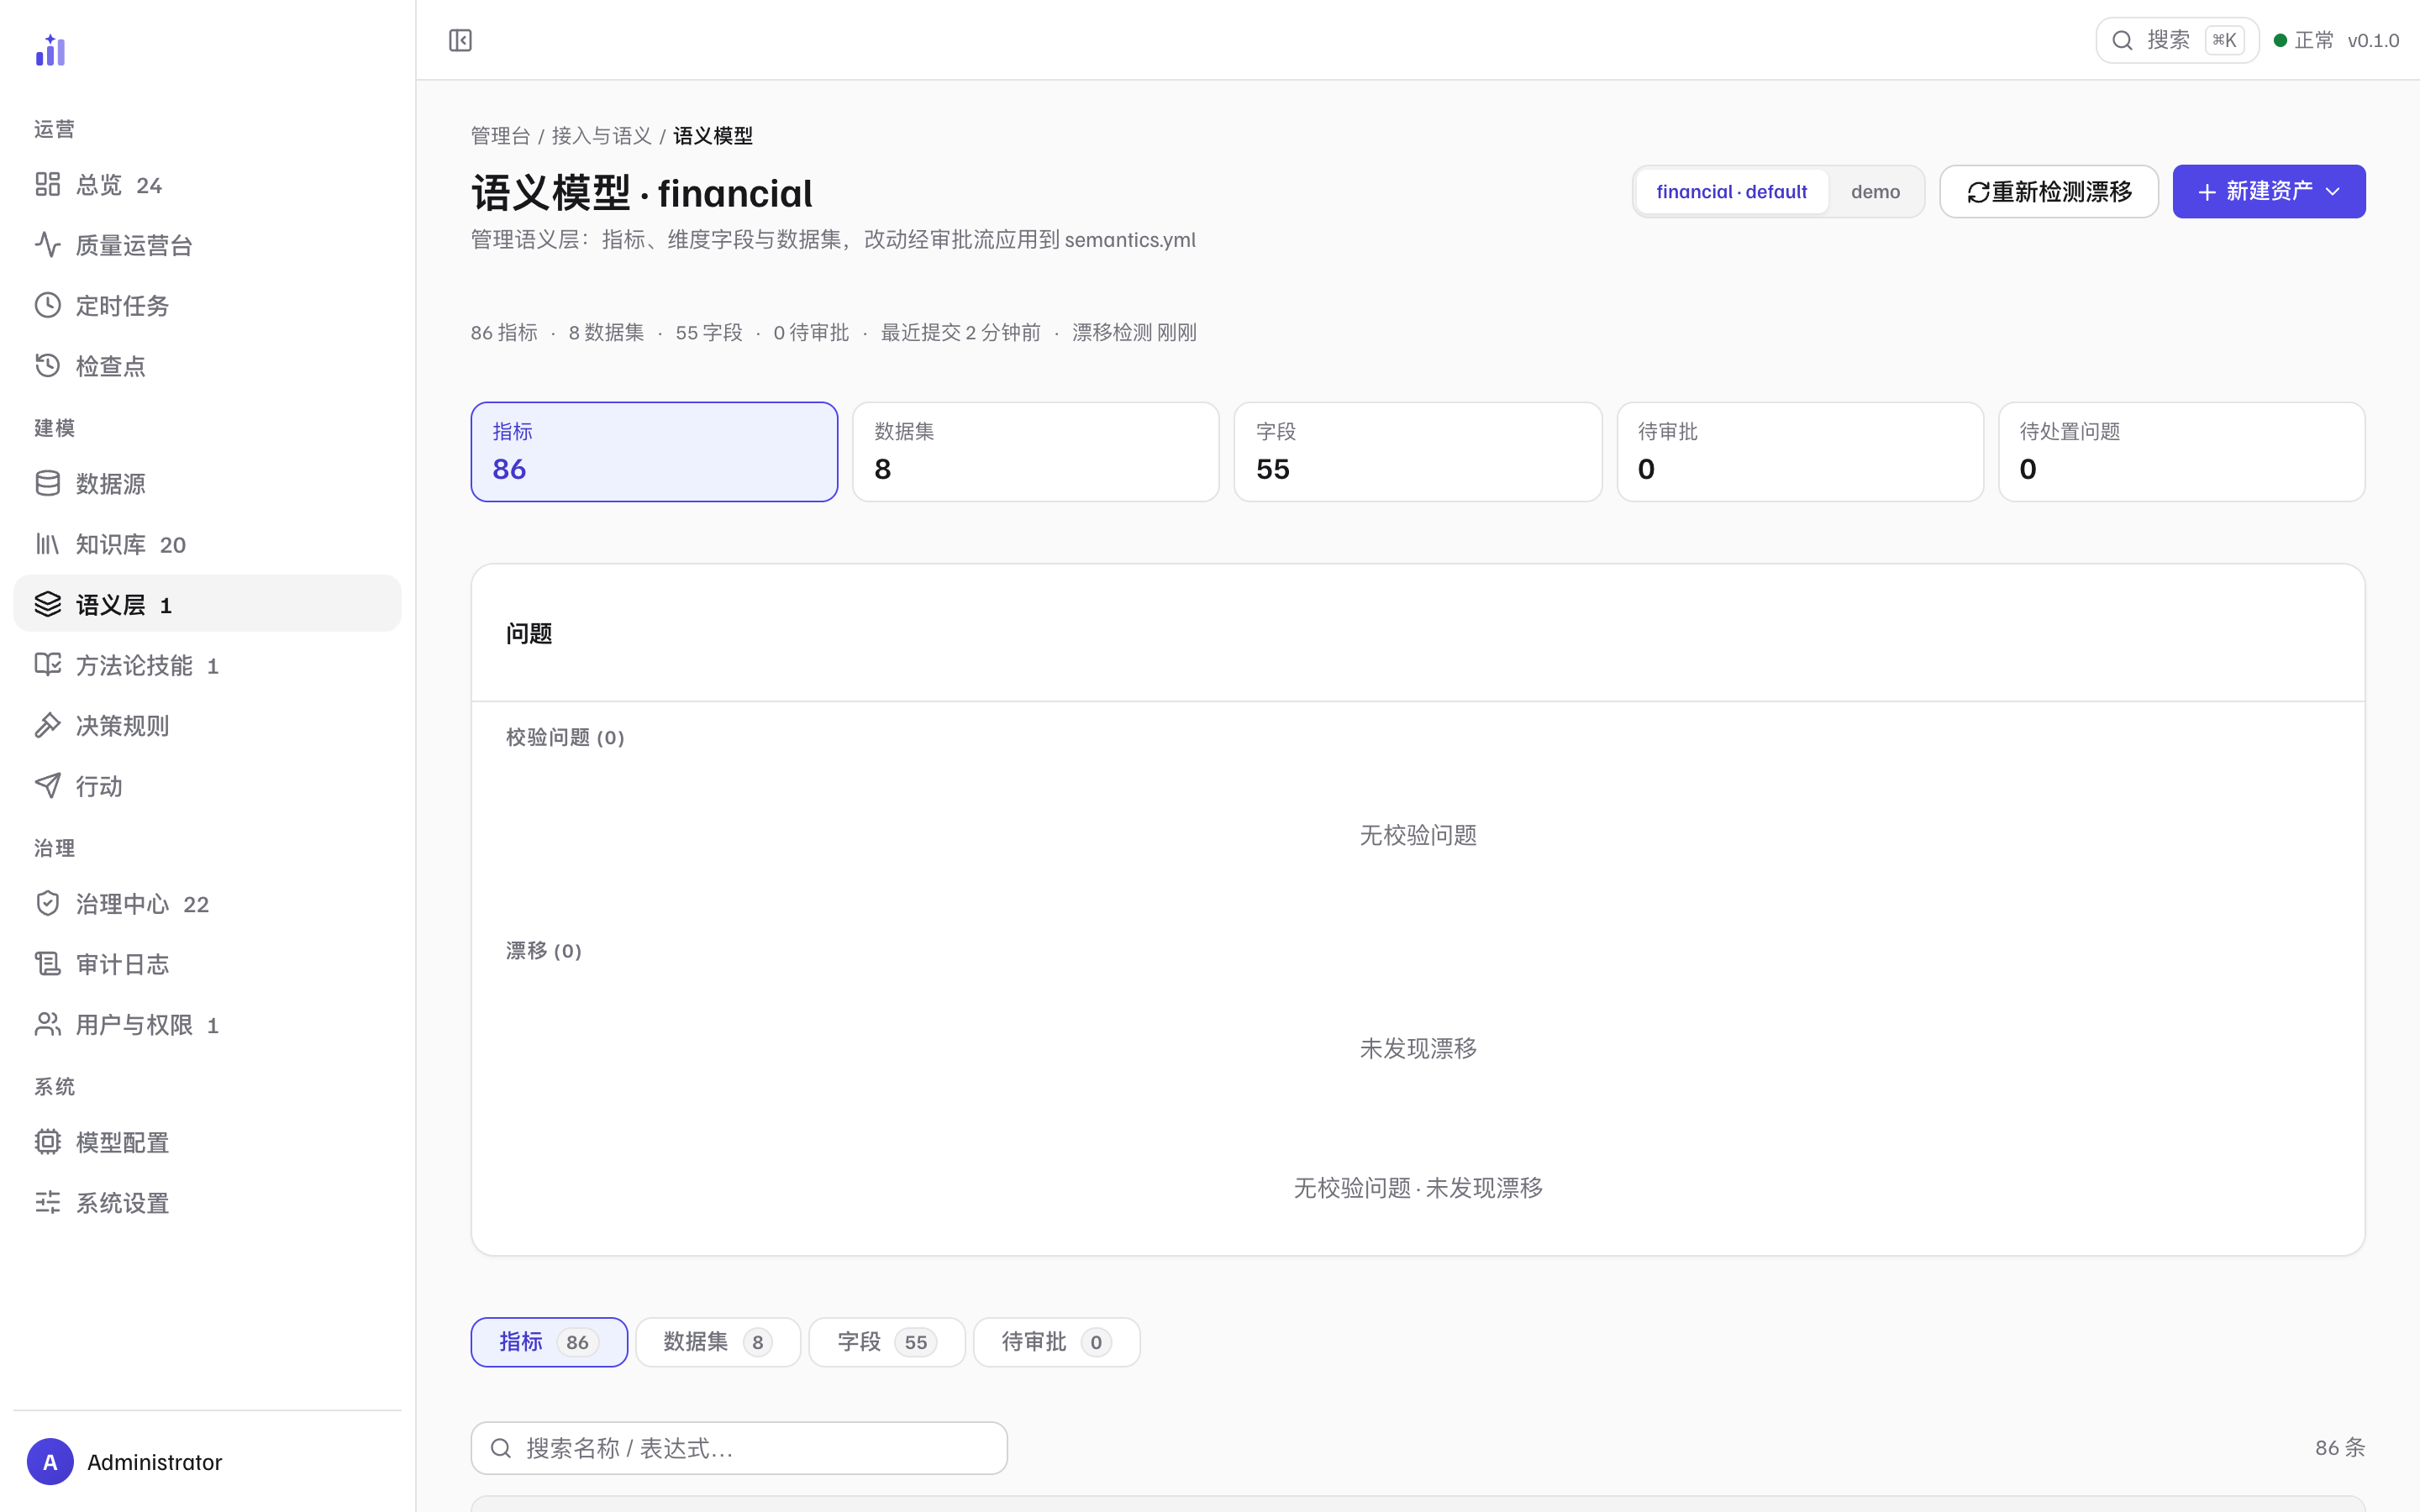
financial):可答边界在这里维护——摘要、问题卡与四类构件的入口同屏。- 1顶栏:数据源切换 + 动作——语义模型按源分开(
financial · default与demo两枚胶囊),切换即换整份模型;「重新检测漂移」手动跑一次库与模型的对照,「新建资产」是四类构件的统一入口。 - 2摘要行——86 指标 · 8 数据集 · 55 字段 · 0 待审批,后面缀着「最近提交 2 分钟前 · 漂移检测 刚刚」:这是一句 freshness 声明,漂移读数过期时它自己会说。
- 3问题卡:校验问题 + 漂移——两节各自列问题;都为空时卡片底部汇总一行「无校验问题 · 未发现漂移」,而不是渲染两张空表。漂移 = 物理库与模型声明的对照结果。
- 4tab 行 + 搜索——指标 / 数据集 / 字段 / 待审批是四类条目的入口(本图 86 条指标选中中);改动一律先落
pending草稿,经审批流应用到semantics.yml。
主题域:把「可答范围」声明成域
模型还可以声明主题域(topics):一个业务域 =
名字 + 数据集清单,外加给人和给检索用的佐料(同义词、指标、示例问句、描述)。
它把「这个数据源里哪些数据集属于哪块业务」从口头约定变成声明,消费面有三处:
用户端的选择器(提问时选域收敛范围)、
定时任务的域引用(写任务时校验)、
以及域级授权(谁可见哪些域)。
models.py:303 TopicDomain models.py:379 topics
运行期只有三件事,全部零 LLM、纯函数(topics.py):
| 步骤 | 口径 |
|---|---|
| 解析选择 | 域名单平台比较(大小写 / 空白不敏感)→ 声明里的那一个。解析不到是显式的失败信号,不静默退回全量——用户选的是范围,范围没了就该说,而不是把问题答在更大的数据上 |
| 算作用域 | 声明数据集 ∩ 模型当前数据集。交集而不是直接采信声明:域写在 YAML 里、模型会随 /kb init 演进,悬空名字只会让作用域比作者以为的更窄;交集为空也是显式状态——empty_scope,域过期,不是「不限制」 |
| 收敛 (入口,不是出口) |
锚定候选的三条通道(词法、字段名、KB/live term 表)一律收敛。收敛放在入口:出口过滤会让域外表先占满候选与上限、再被删掉——域内表可能已经被上限挤出去了。另外引擎唯一一处「自己加表」的指标扩展(沿 metric.datasets 拉表)之后还要再收敛一次:只靠入口过滤挡不住它 |
解析结果四态,每种都对应一句说得出的话:
| 状态 | 含义 |
|---|---|
none | 未选择——行为与不启用主题域字节级一致 |
ok | 命中;作用域 = 声明 ∩ 现有数据集(非空) |
not_found | 名字不在模型里——「域不存在」与「你没被授权」是同一种拒绝(见下) |
empty_scope | 名字在、但声明的数据集已全部不在模型里——域过期 |
名字解析不到、或者域存在但被域级授权挡掉,返回的是同一个
topic_not_found 拒绝。分开写的话,任何一个用户都能拿报错文案当预言机,
逐个试出「哪些域存在」——拒绝文案不能泄露它不该知道的存在性。
拒绝文案里附的可选域清单(available_topics)也按主体过滤:
你看不见的域,既不在选择器里,也不在报错里。域过期的拒绝另成一档
(topic_empty_scope),因为它和「名字写错」处置不同:
改名字没用,得修模型。
作用域只回答「这个问题关于哪些数据集」,不裁剪 join 路径—— 编译器按声明的 join 图补齐中间表是既有语义,主题域不是关系图的裁剪器。 选域是为了收敛入口,不是给跨表分析上锁。
命中后,语义上下文里会多一行确定性的声明:Topic domain: <名> (scope: …)。
渲染给生成侧的是作用域事实(本问收敛在哪些数据集),不是营销文案——
生成据此不再往域外找表。
topics.py:25 TopicResolution topics.py:58 resolve_topic topics.py:81 filter_scoped topics.py:98 render_topic_line schema_linking.py:175 _semantic_match_datasets schema_linking.py:460 allows_topic policy.py:73 visible_topics
编译:三态产出
编译入口有两个。新契约返回三态(成功 / CompileMiss / PartialCompile),
旧契约为了字节级向后兼容只返回两态(任何 MISS 都返回 None):
compiler.py:2917 compile_detailed compiler.py:2888 compile_from_plan compiler.py:1973 SemanticCompiler
flowchart LR
    P["查询计划(query_sketch 产出)"]:::entry --> C["SemanticCompiler.compile_detailed"]:::gen
    M[("semantics.yml")]:::entry --> C
    C -- "全部解析" --> OK["成功:权威 SQL
生成通道基本不参与"]:::entry
    C -- "只缺词表 / 取值 / 口径" --> PC["PartialCompile
骨架 SQL + 交接契约 + 未解析清单"]:::entry
    C -- "结构性问题" --> CM["CompileMiss
携带 reason"]:::gate
    OK --> RUN["执行"]:::exec
    PC --> GEN["生成通道按契约补齐"]:::gen
    GEN --> CHK{"执行前:骨架保真校验
join 边 / WHERE / 分组宽度"}:::gate
    CHK -- "保住了" --> RUN
    CHK -- "丢了" --> RT["打回重生成"]:::entry
    CM --> RF["refuse:拒绝 + 起草扩展草案"]:::gate
    classDef entry fill:#71717a14,stroke:#71717a59,stroke-width:1px;
    classDef gen fill:#6366f114,stroke:#6366f199,stroke-width:1.5px;
    classDef exec fill:#14b8a614,stroke:#14b8a699,stroke-width:1.5px;
    classDef gate fill:#f59e0b14,stroke:#f59e0b99,stroke-width:1.5px;
    linkStyle 9 stroke:#f59e0b,stroke-width:1.5px
is_hard_miss 的调用点。
上面这段以源码显示:图渲染库没加载起来(离线、CDN 被拦或浏览器禁用了 JavaScript 时会这样)。这段 Mermaid 文本本身就说明了上面那些框与连线。
PartialCompile 是这套设计里最特别的一个产物。它同时携带三样东西:
已经编译好的骨架 SQL、一份交给生成通道的交接契约、以及未解析组件的清单。
compiler.py:1374 PartialCompile contract.py:160 PlanContract contract.py:220 render_contract
契约会被渲染成一段文字注入生成提示,但它的作用不是告诉模型「我们做了什么」,而是划定不许改动的部分。模型补完的 SQL 事后要按同一份契约校验。
硬与软的完整判据
分类的权威是这三个集合。每条 reason 落在哪个集合里,是从「放行它会不会产出一个错的数」推导出来的:
compiler.py:1396 MISS_REASONS compiler.py:1437 HARD_MISS_REASONS compiler.py:1456 SOFT_MISS_REASONS compiler.py:1483 is_hard_miss
硬 MISS 逐条
| reason | 触发条件 | 放行会怎样 |
|---|---|---|
| no_plan_or_matched | 没有查询计划、没有匹配到表,或者压根没有语义模型——编译无从开始 | 没有可编译的起点:放行等于让后面每一步都建立在猜测上 |
| fan_out | join 路径上存在声明的行倍增边 | 被聚合的明细行被复制,金额类指标成倍放大 |
| unknown_cardinality | 边的基数未声明,无从判断是否倍增 | 不确定就等于有风险——宁可拒绝 |
| ambiguous_join_path | 两表间存在多条连通路径,或显式 joins 不构成连通树 | 选错路径 = 用另一个口径算,结果看着正常但是错的 |
| unreachable_table | 投影表守卫:产物引用的表不在连接树内 | SQL 引用了一张没被 join 进来的表 |
| table_not_allowed | 引用了数据集白名单之外的表 | 越界访问 |
| derived_cycle / derived_depth / derived_unresolved | 派生指标成环、展开超过深度上限、或定义悬空 | 展开它没有终点,或展开成一个空表达式 |
| metric_anchor_unmatched | 指标的锚定表不在本次匹配到的表里 | 生成的 SQL 会引用未覆盖的表 |
| limit_without_order | 要求 LIMIT 但没有排序依据 | 取到哪些行是不确定的 |
| nothing_compilable | 兜底:一个成分都编译不出来 | — |
| guardrail_rejected | 编译产物未通过语义侧护栏校验 | 产物本身越界 |
判定 fan-out 的地方分两处:显式 joins 走 guard_edge_cardinality,
自动寻路走 BFS,路径上遇到倍增边即拒绝。派生指标的展开深度上限是 5 层。
compiler.py:211 _classify_edges compiler.py:245 guard_edge_cardinality compiler.py:2664 _MAX_INLINE_DEPTH compiler.py:149 JoinResolver
软 MISS 逐条
软 MISS 的共同点是:结构是清楚的,只是某个词/值/口径没登记。 这类问题可以带着缺口继续走,因为缺口的位置是已知的。
| reason | 缺什么 |
|---|---|
| no_metric_match | 问题里的聚合意图没有对应的已声明指标 |
| bad_time_grain / time_field_not_declared / time_field_not_temporal | 时间分桶的粒度未声明、字段不是时间类型 |
| unresolved_answer_column | 要输出的列没有在语义模型里登记 |
| unresolved_filter_field / invalid_op / missing_filter_value | 过滤字段未声明、算子不适用、比较值缺失 |
| enum_value_unresolved | 用到了某个枚举值,但它不在该字段的已声明取值里 |
| having_metric_unknown / having_without_aggregation | HAVING 里点了一个没有声明的指标,或者压根没有可据以过滤的聚合 |
| time_grain_without_aggregation | 要按时间分桶,但没有可以分桶的聚合 |
| analysis_*(六条,见下) | 窗口 / 分析函数这一段没解析出来 |
软 MISS 一共 18 条,表里按「缺什么」归了类;完整的闭集在
SOFT_MISS_REASONS 里,新增 MISS 分支时必须归入软硬两边之一。
窗口与分析函数
语义计划里可以带一段 analysis,编译期展开成窗口函数。支持六种:
share(占整体比例)、running_total(累计)、
mom / yoy(环比 / 同比增量)、pct_change(变化率)、
rank(排名)。它们都是单度量的——窗口计算围绕一个度量展开,
所以计划里必须恰好有一个聚合度量投影。
| reason | 缺什么 |
|---|---|
| analysis_unsupported_type | 类型不在上面六种里,或写成了一个数组 / 空值 |
| analysis_metric_unknown | 点名的度量没声明,或聚合度量不止一个 |
| analysis_partition_unresolved | 分组维度(PARTITION BY 的依据)没解析出来 |
| analysis_order_unresolved | 排序依据没解析出来——累计 / 环比 / 同比没有它就无从下手 |
| analysis_time_required | 这类分析必须沿时间轴走,但计划里没有时间维度 |
| analysis_invalid | 这段 analysis 的形状本身不对(不是对象、内层 SQL 解析不出来) |
注意这些全是软 MISS:窗口那一段交回生成通道按计划文本补齐, 内层的分组与过滤仍然由编译器权威产出。缺一段不该让整条查询停摆。
收集软 MISS 的入口是 _record_soft——它只记录,不中断编译,
所以一次编译能把所有缺口都收集齐,而不是修一个报一个。
compiler.py:2898 _record_soft compiler.py:3598 PartialCompile
is_hard_miss 是 reason → 软硬分类的权威判定函数,但运行时的路由并不是靠调用它决定的,而是靠编译产物的类型:拿到 CompileMiss 就走拒绝路径,拿到 PartialCompile 就走骨架路径。
这个区分在写扩展或调试时很重要——想知道「为什么这次拒绝了」,看的是产出的类型与它携带的 reason,而不是去追 is_hard_miss 的调用点。
骨架保真校验
软 MISS 放行之后,生成通道会拿到骨架和契约去补全 SQL。执行之前有一道校验, 它比对的是三样东西:join 边、WHERE 条件、分组宽度。 投影列不参与比对——补全本来就可能调整输出列,那不是破坏契约。
compiler.py:4346 skeleton_preserved compiler.py:4522 compiled_sql_matches execute_sql.py:192 skeleton_preserved
校验有两种失败方式:SQL 解析不了,或者解析出来发现丢了骨架里的东西。 两种都会把这一轮打回重生成,而不是带着一个已破坏权威性的 SQL 去执行。
execute_sql.py:197 _compile_drift_failure
行级安全:在编译期注入
数据集可以声明一个 row_filter——一个恒真的布尔 SQL 谓词。
编译时,每个引用该数据集的查询都会被注入这个谓词到顶层 WHERE。
models.py:252 row_filter rls.py:99 inject_row_filters rls.py:75 render_row_filter
注入失败时(谓词渲染不出来、SQL 结构不认),系统放弃这条路径而不是跳过过滤。快径命中模板后也要单独注入一次——它不经过编译器,所以必须自己补上这一步,注入失败就退回编译路径。
rls.py:30 RLSInjectionError fast_match.py:502 rls_applied
但这份机制有一条明确的边界,不该被误读成安全保证: 声明层的行过滤不替代数据库侧的只读角色。它的作用是让「同一个语义模型下的所有查询」 口径一致,而不是防止有人绕过 Trove 直接连库。
声明式 API 的严格契约
如果是通过声明式 API 调语义层(而不是走对话工作流),契约会变得更严格:
遇到 PartialCompile 直接返回 422,而不是降级补全。
query.py:185 compile_detailed query.py:190 PartialCompile
理由很直接:程序调用方拿到一个「补全过的」SQL,它无法判断哪些部分是权威的、哪些是模型填的。 而对话场景里用户可以看见解释、可以追问。所以同一个语义层,两种调用方,两套契约。
继续读
| 想了解 | 去哪 |
|---|---|
| 概念层面的可答边界与逃生梯 | 产品概念 |
| 编译边界的完整推导(硬/软 MISS、骨架保真、草稿免确认的验证门) | 深潜 · 语义编译边界 |
| 指标、字段、枚举从哪来(KB 五件套) | 知识库 |
| 数据集怎么变成对象、关系怎么带业务名、维度链怎么声明成层级 | 本体 |
| 成批改这份模型时怎么先看 diff、回放与影响面再合入 | 语义层治理 · 变更评审 |
| 同一份模型还有别的消费者吗 | 判定规则、行动与审批 |
| 用户端怎么用主题域收敛提问 | 提问与读懂答案 · 主题域 |
| 域级授权怎么配置 | 用户·权限·安全 |
| 编译器在图上哪一步被调用 | 查询工作流 |
| 拒绝之后管理端怎么处置 | 运维管理 |